让 AI 自己去查数据:宝可梦攻略助手从零到上线
怀旧重玩宝可梦,查攻略太麻烦,于是用 Next.js + AI SDK + PokeAPI 做了个能用任何语言提问的攻略助手。这篇是从空目录到上线的完整过程:工具调用怎么写、一次提问为什么会打出十几次请求、怎么教它承认自己不知道。
最近怀旧重玩宝可梦这个游戏,有时遇到迷宫、关卡或属性相关的问题,都会去搜索引擎查找攻略,但搜索起来比较麻烦,于是有了做一个能用任何语言提问的宝可梦攻略网站的想法。你可以问它属性克制、进化条件、迷宫走法,它会实时查数据并用你的语言回答。
这篇是从空目录到上线的完整过程,照着步骤走就行。
先看清楚你要做什么
成品是一个聊天页面。用户问「喷火龙怕什么属性」,AI 不凭记忆回答,它自己去查数据库,拿到「火/飞行、岩石 4 倍」这些确定的数据,再组织成中文回答。
这个"让 AI 自己去查"的能力叫工具调用,整个项目就靠它,STEP 3 细讲。
你需要准备
| 东西 | 说明 |
|---|---|
| Node.js 20 以上 | 命令行敲 node -v 能看到版本号就行 |
| 一个代码编辑器 | VS Code 之类 |
| 一个大模型 API key | 下面详细说,有免费的 |
| 会用命令行 | 只需要会 cd 和复制粘贴命令 |
不需要:数据库、服务器、机器学习知识。宝可梦数据用免费的公开接口 PokeAPI,不用注册也不用 key。
先算一笔账,别做到一半才发现
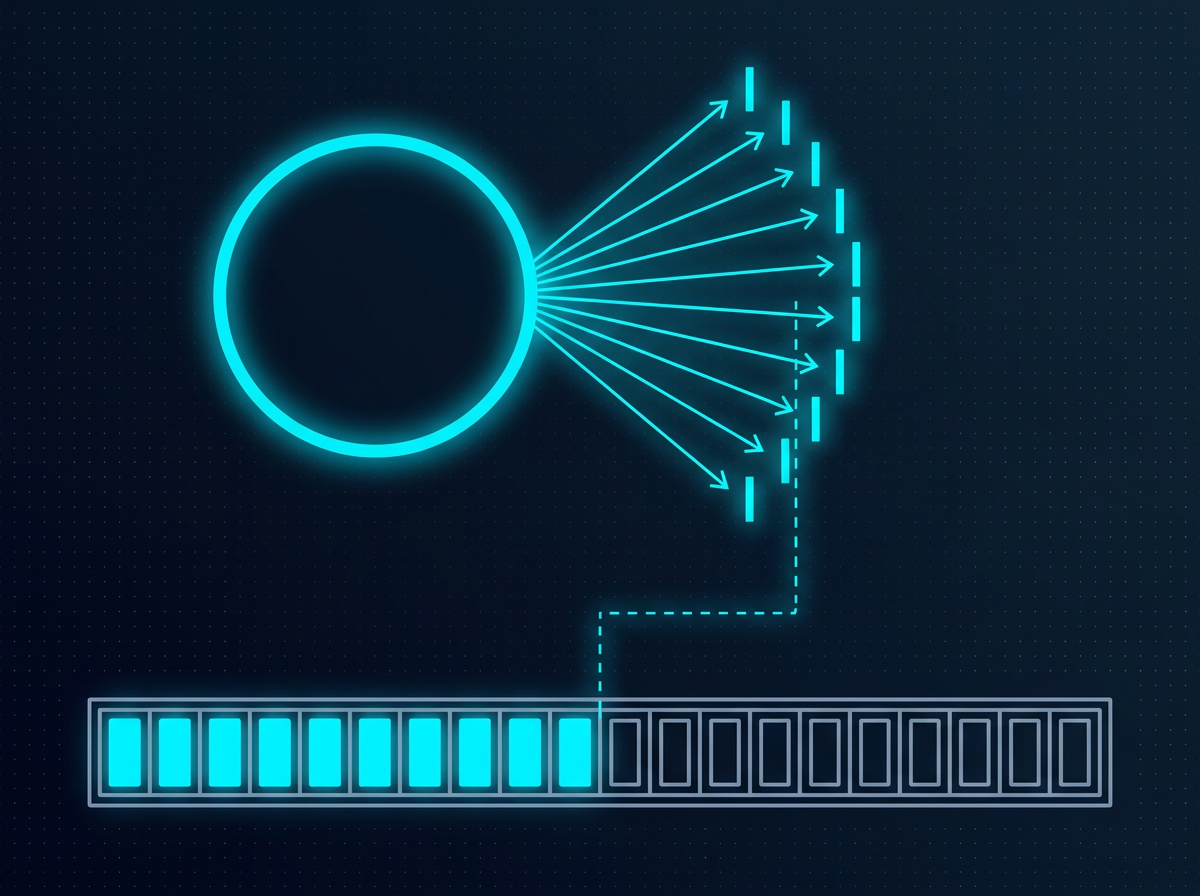
一次提问不等于一次 API 请求。 这条放最前面,因为它最容易踩。
用户问「伊布的 8 种进化怎么选」,AI 会先查进化链,再逐个查 8 只宝可梦的数据,每查一次都要重新请求模型一次让它继续。一个问题打出去 10 次请求。
STEP 1 · 搭一个能跑的空架子
打开命令行,创建项目。全部选默认即可:
npx create-next-app@latest pokemon-ai --typescript --tailwind --app --src-dir --yes
cd pokemon-ai
npm run dev
✅ 怎么确认成功:浏览器打开
http://localhost:3000,能看到 Next.js 的默认欢迎页。
接着装 AI 相关的包(先按 Ctrl+C 停掉刚才的 dev):
npm i ai zod
npm i @ai-sdk/google        # 用 Gemini
npm i @ai-sdk/react         # 前端聊天界面用
ai 是 Vercel 的 AI SDK,负责跟大模型打交道;zod 用来描述工具的参数长什么样;@ai-sdk/google 是 Gemini 的适配层。
STEP 2 · 拿到 key,让它能说第一句话
拿 key
去 Google AI Studio 创建一个 API key(免费)。在项目根目录建一个文件 .env.local:
GOOGLE_GENERATIVE_AI_API_KEY=你的key粘贴到这里
GOOGLE_MODEL=gemini-2.5-flash
⚠️ 两件事关于 key:
①
.env.local千万不要提交到 Git。Next.js 生成的.gitignore默认已经忽略它了,别手动改动这条规则。② 模型名会过期。 别照抄教程里的名字(包括这篇)。用这条命令查当前真实可用的模型:
curl -s https://generativelanguage.googleapis.com/v1beta/models \
  -H "x-goog-api-key: 你的key" | grep '"name"'
写后端接口
新建 src/app/api/chat/route.ts。这个文件的作用是:接收前端发来的对话,转发给模型,把模型的回答一个字一个字地流回前端。
import { ToolLoopAgent, createAgentUIStreamResponse } from "ai";
import { createGoogleGenerativeAI } from "@ai-sdk/google";

const google = createGoogleGenerativeAI({
  apiKey: process.env.GOOGLE_GENERATIVE_AI_API_KEY,
});

export async function POST(req: Request) {
  const { messages } = await req.json();

  const agent = new ToolLoopAgent({
    model: google(process.env.GOOGLE_MODEL!),
    instructions: "你是一位宝可梦攻略助手,用中文回答。",
  });

  return createAgentUIStreamResponse({ agent, uiMessages: messages });
}
为什么要"流"回去? 模型生成一段长回答要十几秒。如果等全部生成完再返回,用户会盯着空白页面等。流式输出是边生成边显示,体验完全不同。这部分 SDK 已经处理好了,你只要用 createAgentUIStreamResponse。
写前端页面
把 src/app/page.tsx 整个替换成:
"use client";

import { useChat } from "@ai-sdk/react";
import { DefaultChatTransport } from "ai";
import { useState } from "react";

export default function Page() {
  const { messages, sendMessage, status } = useChat({
    transport: new DefaultChatTransport({ api: "/api/chat" }),
  });
  const [input, setInput] = useState("");

  return (
    <div className="mx-auto max-w-2xl p-6">
      {messages.map((m) => (
        <div key={m.id} className="my-3">
          <b>{m.role === "user" ? "你" : "助手"}:</b>
          {m.parts.map((p, i) =>
            p.type === "text" ? <span key={i}>{p.text}</span> : null
          )}
        </div>
      ))}

      <form onSubmit={(e) => {
        e.preventDefault();
        if (input.trim()) { sendMessage({ text: input }); setInput(""); }
      }}>
        <input
          className="w-full rounded border p-2"
          value={input}
          onChange={(e) => setInput(e.target.value)}
          disabled={status !== "ready"}
          placeholder="问点什么…"
        />
      </form>
    </div>
  );
}
"use client" 这行必须在最顶上,它告诉 Next.js 这个组件要在浏览器里跑,因为要处理输入和点击。
✅ 怎么确认成功:
npm run dev,打开页面,随便问一句「你好」。应该看到回答一个字一个字冒出来,而不是等一会儿整段出现。看到回答了就说明 key 有效、模型通了、流式输出正常。
STEP 3 · 工具调用,让它自己去查
现在的助手能聊天,但它报的数据不可靠。你问「喷火龙种族值多少」,它可能凭印象编一个。
先理解工具调用
你问朋友「今天上海几度」,他有两种答法:
- 凭记忆:「大概二十几度吧」(可能错)
- 查一下:掏手机打开天气 App,看到 23℃,告诉你「23 度」(准确)
工具调用就是给 AI 那个"手机"。你提供一个函数,告诉它「这个函数能查宝可梦数据,什么时候该用它」。AI 自己决定要不要调用、传什么参数,拿到结果后再组织成人话。
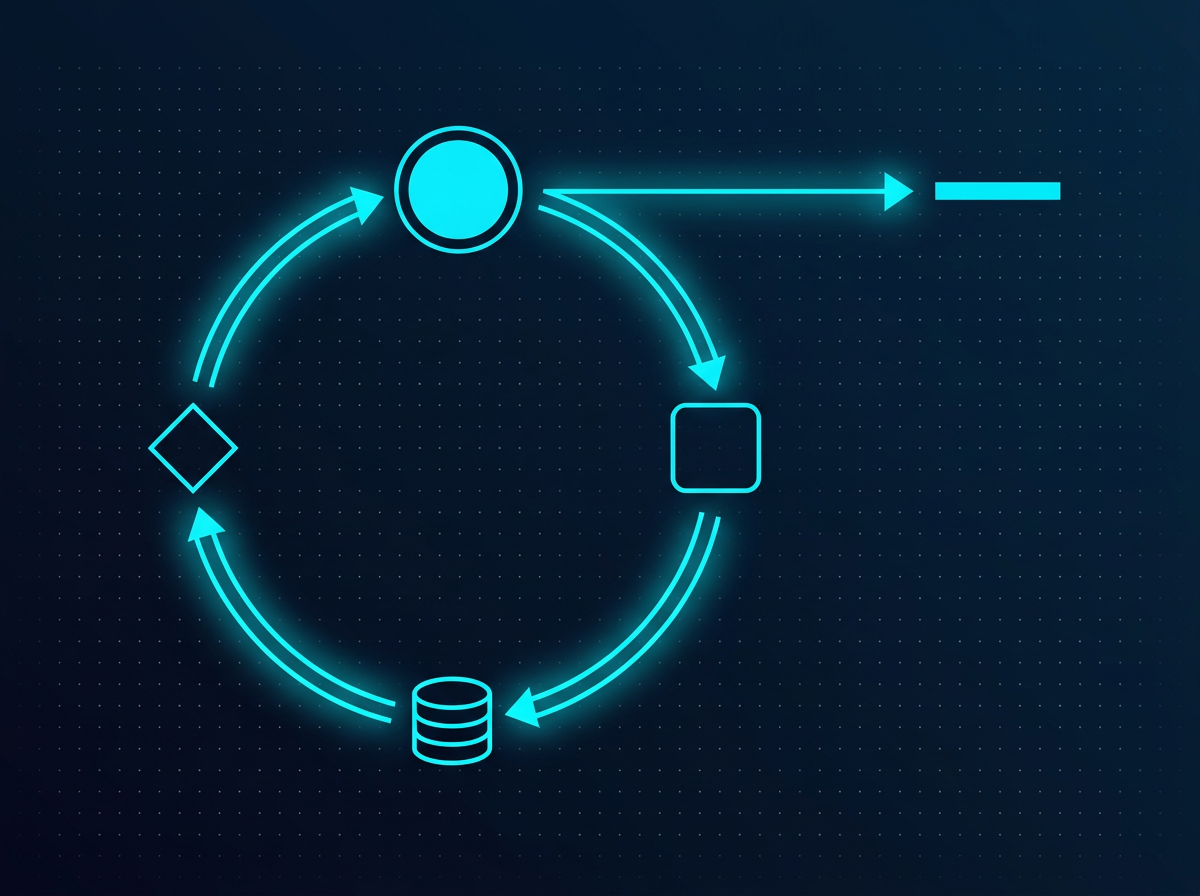
整个过程 SDK 会自动循环:AI 说"我要查喷火龙" → SDK 执行你的函数 → 把结果给 AI → AI 说"我还要查克制关系" → 再执行…… 直到它给出最终回答。这也是为什么一个问题会产生十几次请求。
写第一个工具
新建 src/lib/tools.ts:
import { tool } from "ai";
import { z } from "zod";

export const pokemonTools = {
  getPokemon: tool({
    // description 是给 AI 看的说明书,写清楚"什么时候用"最重要
    description:
      "查询一只宝可梦的属性、种族值、特性、图鉴说明。" +
      "回答任何涉及具体数值的问题前都必须调用它,不要凭记忆作答。",

    // inputSchema 描述参数。AI 会照这个格式传值
    inputSchema: z.object({
      name: z
        .string()
        .describe("英文小写名,如 pikachu、charizard。中文名要先翻译成英文"),
    }),

    // execute 是真正干活的函数
    execute: async ({ name }) => {
      const res = await fetch(
        `https://pokeapi.co/api/v2/pokemon/${name.toLowerCase()}`
      );
      if (!res.ok) {
        // 关键:报错要写成"指令",AI 看懂后会自己改正重试
        return {
          error: true,
          hint: "没查到。请确认用的是英文小写名,比如 pikachu、mr-mime。",
        };
      }
      const d = await res.json();
      return {
        name: d.name,
        types: d.types.map((t: { type: { name: string } }) => t.type.name),
        stats: Object.fromEntries(
          d.stats.map((s: { stat: { name: string }; base_stat: number }) => [
            s.stat.name,
            s.base_stat,
          ])
        ),
      };
    },
  }),
};
然后在接口里挂上它 —— 只加一行:
import { pokemonTools } from "@/lib/tools";

const agent = new ToolLoopAgent({
  model: google(process.env.GOOGLE_MODEL!),
  instructions: "你是一位宝可梦攻略助手,用中文回答。",
  tools: pokemonTools,          // ← 加这一行
});
✅ 怎么确认成功:问「喷火龙的属性和种族值」。回答里应该出现准确的数字:火/飞行,种族值 HP 78、攻击 84、特攻 109、速度 100。
如果数字对得上,说明 AI 真的去查了而不是编的。
再加几个工具
照同样的模式,把这些接口包成工具,助手的能力就完整了:
| 工具 | PokeAPI 接口 | 能回答什么 |
|---|---|---|
getEvolutionChain | /evolution-chain/{id} | 进化条件(等级、道具、亲密度) |
getPokemonMatchup | /type/{name} | 弱点、几倍伤害 |
getMove | /move/{name} | 招式威力、命中、附加效果 |
getItem | /item/{name} | 道具效果 |
getEncounters | /pokemon/{id}/encounters | 野生出现地点 |
⚠️ 属性克制要自己算。 PokeAPI 只给「火被水克制」这种单属性关系。喷火龙是火 + 飞行双属性,被岩石打是 2×2 = 4 倍,这个乘法得你自己写,把两个属性的倍率相乘。用户最容易在这里发现你算错。
STEP 4 · 多语言
模型本身就会多语言,这步几乎不用做什么,在指令里说清规则就行:
用简体中文回答。
但如果用户的提问明显使用了另一种语言,就跟随用户提问所用的语言 ——
用户的实际用语优先于界面设置。
宝可梦、招式、道具都用该语言的官方译名。
PokeAPI 本身也自带各语言官方译名。它的 names 字段长这样:
[
  { "language": { "name": "zh-hans" }, "name": "皮卡丘" },
  { "language": { "name": "ja"      }, "name": "ピカチュウ" },
  { "language": { "name": "en"      }, "name": "Pikachu" }
]
所以更好的做法是让工具直接返回目标语言的名字,不必让模型自己翻译。用工厂函数把语言"包进"工具里:
// 改成函数,构造时就把语言固定下来
export function createPokemonTools(lang: string) {
  return {
    getPokemon: tool({
      // …
      execute: ({ name }) => getPokemon(name, lang),   // lang 被闭包捕获
    }),
  };
}
好处是模型不需要自己传语言参数,也就不会漏传。前端把当前语言随请求发过来,接口用它构造工具就行。
STEP 5 · 教它承认不知道
用户最想问的其实是「月见山的迷宫怎么走」。但 PokeAPI 没有迷宫路线数据,它只有地点名称,没有"往左走、下楼梯"这种信息。
这时候如果什么都不管,模型会编。它会给你一段看起来非常具体的路线,带着自信的方位和步数,但可能是错的,而用户没法分辨。
解决办法是在指令里把两类问题分开定规则:
## 数据准确性

任何涉及具体数值的问题,都必须先调用工具查询,绝不能凭记忆回答:
- 种族值、属性、特性、捕获率 → getPokemon
- 进化条件 → getEvolutionChain
- 属性克制、弱点 → getPokemonMatchup

## 迷宫与剧情攻略

工具里没有迷宫内部路线数据。回答这类问题时依据你自己的游戏知识作答,
并遵守:

1. 先确认版本。同一个迷宫在不同版本里结构不同。如果用户没说版本,
   要明确标注你假设的是哪个版本。
2. 分步骤写,每步说清方向、标志物、要用的招式或道具。
3. 诚实标注不确定的地方。如果某段路线你记得不牢,就直接说明这一段
   建议对照图文攻略确认,不要编造具体的转向步数。
   编造的路线比承认不确定有害得多。
✅ 怎么确认成功:问「月见山的迷宫怎么走」。回答开头应该主动出现版本声明,类似「本攻略以《火红/叶绿》的地图结构为基准,若你在玩《金/银》,二周目的月见山内部已大幅缩水」。
看到它主动交代前提,就说明这条指令生效了。
STEP 6 · 部署上线之前
准备部署上线之前先想清楚一件事:你的 /api/chat 是一个按次花钱的公开接口,默认没有任何限制。任何人拿到网址,写个循环脚本就能把你的额度或钱刷光。
最少要加三层:
| 防护 | 作用 | 怎么做 |
|---|---|---|
| 机器人验证 | 挡掉脚本和爬虫 | 部署在 Vercel 可用 BotID,几行配置 |
| 限流 | 挡单个来源刷量 | 按 IP 限每分钟次数,再加一个全站总量限制 |
| 输入长度上限 | 防止一次塞进巨量内容 | 限制消息条数和总字数 |
⚠️ 限流有个反直觉的地方:按分钟限流保护不了日额度。全站限 20 次/分钟,一天仍然能放行 28800 次,而日额度只有 20 次。
分钟限流防的是突发流量。守日额度只能靠付费层。
Vibe Coding 的几条经验
这个项目本身就是 Vibe Coding 做出来的。几条能明显提速的经验:
别信它对库 API 的记忆
AI SDK 这类库更新很快,助手记住的往往是旧版本的写法,写出来跑不通再来回改,很浪费时间。
直接让它去读你项目里装好的那份文档。很多库会把文档随包发布,就在 node_modules/<包名>/docs/ 下面。让 AI 先读那里,再动手写。
模型名让它去查,不要让它猜
同理。模型名过期得很快,猜错会得到 404。直接让它调 provider 的模型列表接口。
让验证不花钱
额度紧张的时候,验证方式本身要设计。几个实用技巧:
- 用假 key 验证整条链路。 填一个格式对但无效的 key,如果拿到「key 无效」的报错,说明请求确实发出去了,除了 key 之外全通。这一步不花额度。
- 把限流阈值临时设成 0 来测限流。 请求在调模型之前就被拦下,所以完全不消耗额度。
- 强制触发边界情况。 要测截断提示,把输出上限临时设成 400,一次就能触发,不用等它自然发生。
让它说清哪些没验证
类型检查通过、构建成功,只能证明代码语法对、能打包,证明不了点下去真的能用。剪贴板、滚动、本地存储这类浏览器行为,得有人在浏览器里点一下。
所以让它把「验证到什么程度」和「没验证什么」分开说,别接受笼统一句「已完成」。
最后
有了 AI 之后,检索最好的办法就是让 AI 给你实现一个私人助手,它可以量身定制,比现在网上很多攻略网站要更好用。
后续还可以加入记忆功能,让 AI 越来越懂你,搜索起来更准确。