QWen 3.8 27B 新手部署指南
Qwen3.8-27B 本地部署新手指南:llama.cpp router + pi 在 M4 Pro 上从下模型到跑通 agent,实测 11.4 tok/s。四个真踩进去的坑,以及当模型每秒只吐 11 个 token 时,prompt 该怎么写才能一次成型。
最近 Qwen 3.8-27B 很火,因为它几乎能达到近似 Opus 4.6 的效果。去年底,使用 Opus 4.6 可以干很多活了,如果将 Qwen 3.8-27B 部署在本地,相当于有了无限 token 的 Opus 4.6。但在部署过程中还是遇到一些曲折,老金将它们总结成这篇新手指南文章,供大家阅读。
为什么是这套组合
老金本地部署的组合是 pi + llama.cpp + Qwen3.8-27B。
llama.cpp 负责把模型跑起来。相比 Ollama,它的 router 模式允许一个常驻进程管理多个 GGUF、按需装卸,并且暴露标准的 OpenAI 兼容接口,任何支持自定义 base URL 的客户端都能接。
pi 是 harness,把"模型"变成"能读写文件、能执行命令的 agent"的那一层。它自带 llama.cpp 的一等支持,这点后面会看到既是优势也是坑。
Qwen3.8-27B 在 Q4_K_M 量化下约 16.8 GB,64GB 内存的 M4 Pro 跑起来毫无压力。它带 vision projector 和原生 tool calling,后者是做 agent 的硬门槛。
前提:本文假设你已经装好 Homebrew 和 Node 22.19+(pi 通过 npm 分发),以及 18 GB 以上的可用磁盘空间。
部署三步:从下载到跑通
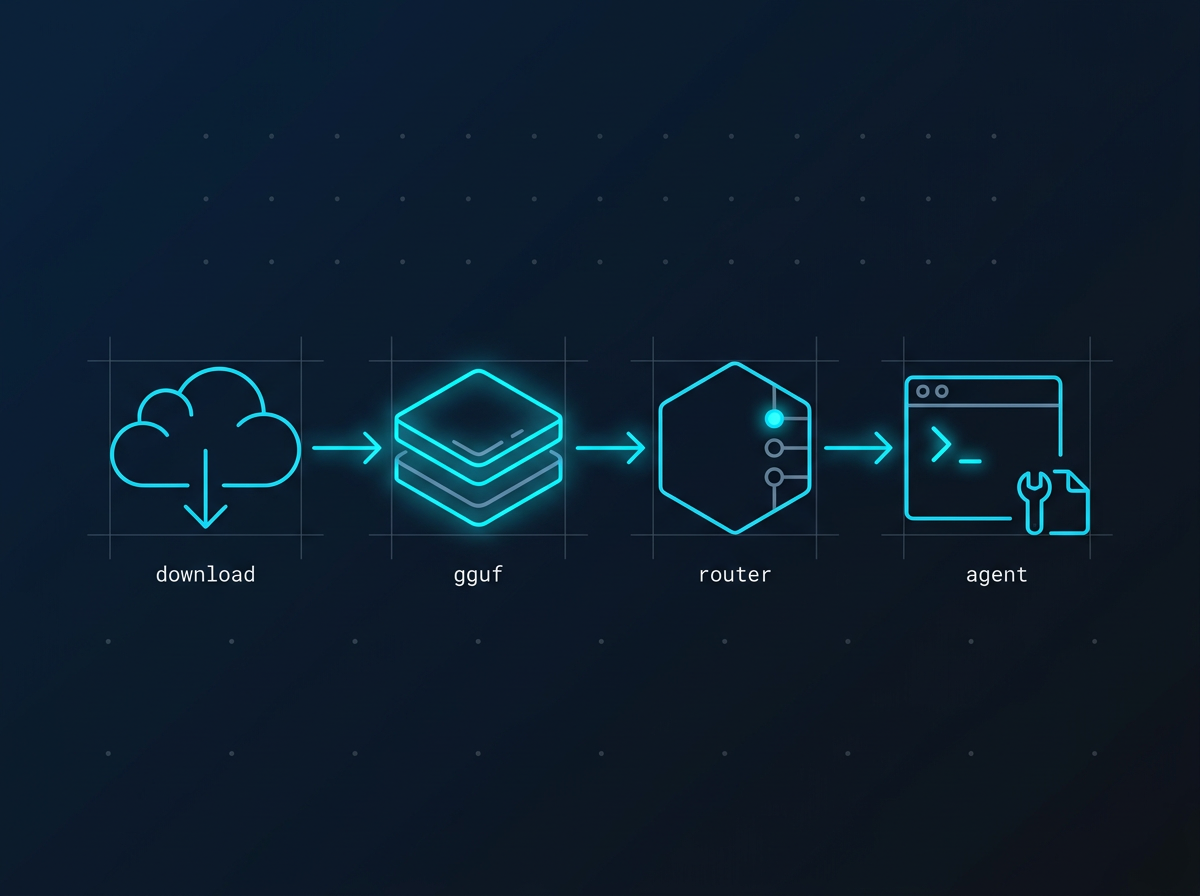
下载模型
要下两个文件:GGUF 本体(Q4_K_M 约 16.8 GB)和 vision projector(mmproj,约 1.4 GB)。后者别漏,router 靠它开多模态,缺了图片输入就是不可用。
别用浏览器点下载。17 GB 中途断一次网就得从头来,用官方 CLI 走,它自带断点续传和并发分片:
pip install -U "huggingface_hub[cli]"

mkdir -p ~/models/Qwen3.8-27B-Q4_K_M

# 新版命令是 hf,老的 huggingface-cli 还能用但已标记废弃
hf download Qwen/Qwen3.8-27B-GGUF \
  Qwen3.8-27B-Q4_K_M.gguf \
  mmproj-F16.gguf \
  --local-dir ~/models/Qwen3.8-27B-Q4_K_M
--local-dir 一定要加。不加的话文件会落进 ~/.cache/huggingface 的哈希目录结构里,你拿到的路径是一堆摘要文件名,router 扫不出来,之后还得自己捞。
国内网络慢的话换个镜像端点,命令不用改:
export HF_ENDPOINT=https://hf-mirror.com
下完先确认它确实是 GGUF,顺便看一眼架构标识:
head -c4 ~/models/Qwen3.8-27B-Q4_K_M/Qwen3.8-27B-Q4_K_M.gguf
# → GGUF
# 头部元数据里 general.architecture = qwen35

ls -lh ~/models/Qwen3.8-27B-Q4_K_M/
# Qwen3.8-27B-Q4_K_M.gguf   16.8G
# mmproj-F16.gguf            1.4G
mmproj 的文件名必须以 mmproj- 开头,router 认的是这个前缀,不是文件内容。仓库里如果叫别的名字,下完自己 mv 一下。
启动 llama.cpp router
brew install llama.cpp
装完先确认两件事。一是这个 build 认不认识 Qwen3.8 的架构标识 qwen35,新模型经常跑在旧版本前面;二是 Metal 后端在不在。
llama-server --list-devices
# Available devices:
#   BLAS: Accelerate
#   MTL0: Apple M4 Pro (53084 MiB, 53083 MiB free)   ← 要看到这行
然后以 router 模式启动。关键是不要传 -m 或 --model。一旦传了,它就退化成单模型模式,router 的按需装卸就没了。
llama-server \
  --models-dir ~/models \
  --no-models-autoload \
  --jinja \
  --host 127.0.0.1 --port 8081 \
  -ngl 999 -c 32768 --flash-attn on
--jinja启用模型自带的 chat template,tool calling 依赖它-ngl 999尽可能多的层交给 GPU-c 32768每个 slot 的上下文。这个模型原生支持 262144,但全开的话 KV cache 会吃掉大量内存
curl -X POST http://127.0.0.1:8081/models/load \
  -H 'Content-Type: application/json' \
  -d '{"model":"Qwen3.8-27B-Q4_K_M"}'

# 27B 装载约 22 秒,轮询 GET /models 看 status
接入 pi
pi 通过 npm 全局安装。这里有两个容易踩的点:包名和命令名不一样,以及它对 Node 版本有硬要求(engines 写的是 22.19+),Node 20 上启动会直接被引擎检查拦掉。
node -v    # 低于 v22.19 先升,nvm 用户记得 nvm use

npm i -g @earendil-works/pi-coding-agent
# 装的是 @earendil-works/pi-coding-agent,可执行文件叫 pi

pi --version
pi 内置了 llama.cpp provider,文档里写的是进 TUI 后执行 /login llama.cpp,填入 router 地址,之后用 /llama 装卸模型、/model 选择模型。这条路是通的,而且能在 pi 里直接搜索下载 HuggingFace 上的 GGUF,体验最好。
坑: provider_not_found 但这个内置 provider 只在 TUI 里注册。一旦你想用
pi -p做非交互调用,或者跑pi auth check --provider llama.cpp,都会得到provider_not_found。脚本化场景下这条路直接堵死。
解法是再配一份 ~/.pi/agent/models.json,把 router 当作普通的 OpenAI 兼容服务接入。两条路指向同一个 router,互不冲突:
{
  "providers": {
    "llamacpp": {
      "baseUrl": "http://127.0.0.1:8081/v1",
      "api": "openai-completions",
      "apiKey": "local",
      "compat": {
        "supportsDeveloperRole": false,
        "supportsReasoningEffort": false,
        "thinkingFormat": "qwen-chat-template"
      },
      "models": [{
        "id": "Qwen3.8-27B-Q4_K_M",
        "reasoning": true,
        "input": ["text", "image"],
        "contextWindow": 32768,
        "maxTokens": 16384,
        "samplingParams": {
          "temperature": 1.0, "top_p": 0.95,
          "top_k": 20, "min_p": 0.0
        }
      }]
    }
  }
}
几个字段值得解释:
apiKey填个占位符就行,llama.cpp 不校验。但 pi 要求模型有 auth 配置才会在/model里显示,留空会导致模型"加载了但选不到"。thinkingFormat: "qwen-chat-template"是关键。Qwen3.8 的 chat template 里带enable_thinking/preserve_thinking两个开关,这个格式会把 pi 的思考等级翻译成对应的chat_template_kwargs。填错的话思考链要么关不掉,要么开不起来。supportsReasoningEffort: false,llama.cpp 不认 OpenAI 的reasoning_effort参数,不关掉会报错。samplingParams直接用了 Qwen 官方推荐值(模型卡和仓库里的generation_config.json都有)。
配好之后验证:
pi --list-models | grep llamacpp
# llamacpp  Qwen3.8-27B-Q4_K_M  32.8K  16.4K  yes  yes

pi -p --model llamacpp/Qwen3.8-27B-Q4_K_M "读取 calc.py 并修复其中的 bug"
性能实测:11.4 tok/s 意味着什么
同机对比,均为 4-bit 级别量化,均运行在 Metal 上:
| 指标 | llama.cpp Q4_K_M | MLX 4-bit |
|---|---|---|
| 解码速度 | 11.4 tok/s | 15.4 tok/s |
| 预填充(11.6k prompt) | 88.7 tok/s | 95.9 tok/s |
| 相同 prompt 重发 | 0.38 s | 需手动开启 |
| 权重体积 | 16.8 GB | 16.1 GB |
解码慢 35%,但这不是配置问题
llama.cpp 在 Apple Silicon 上的解码确实不如 MLX,瓶颈在权重的内存带宽,不在内存容量。每生成一个 token 都要把 16.8 GB 权重完整读一遍,M4 Pro 约 273 GB/s 的带宽算下来上限就在 16 tok/s 附近。内存够用就行,富余多少不影响。
怎么确认真的跑在 GPU 上 除了
--list-devices,更直接的办法是生成过程中看进程 CPU 占用。老金实测是 3–7%。如果掉回 CPU 推理,这个数字会是 600% 以上。
prompt cache 比解码速度重要
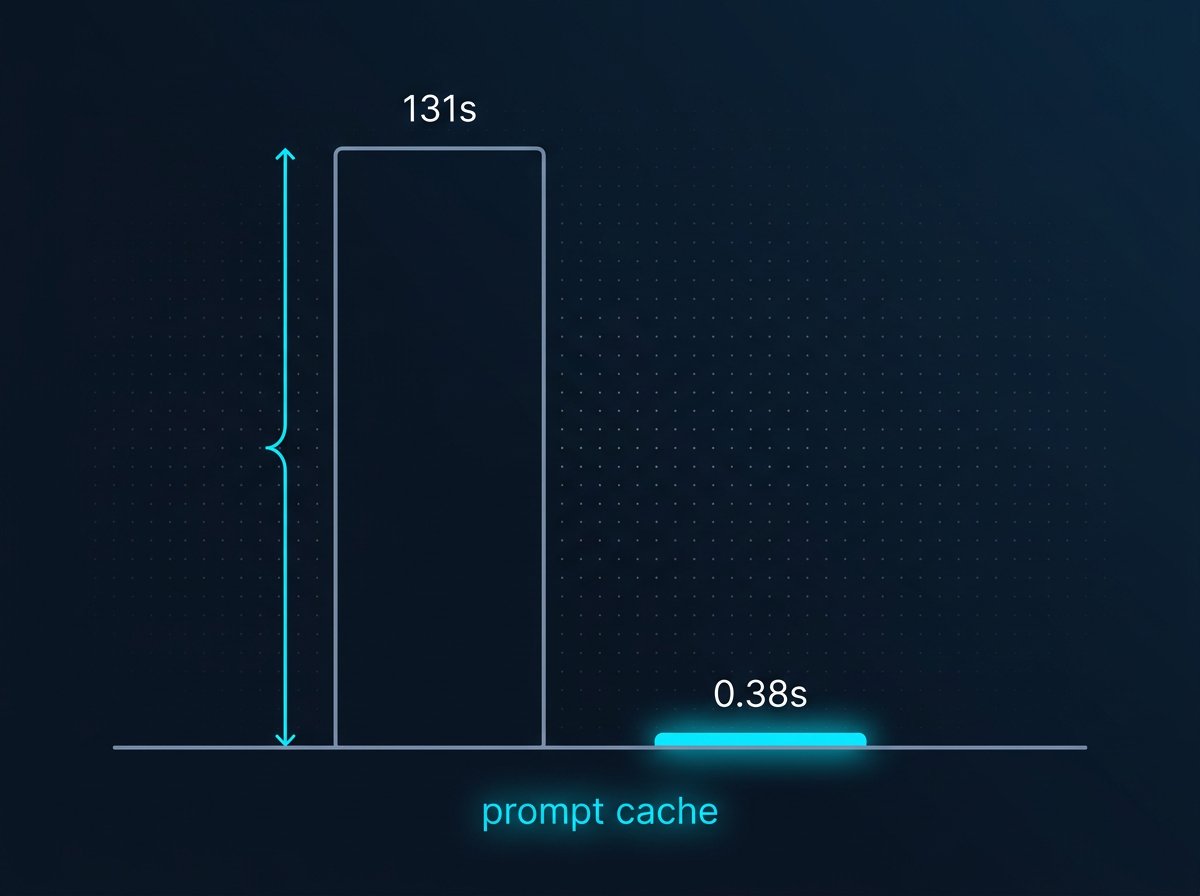
预填充两者几乎持平,因为这个阶段是计算受限而非带宽受限。11.6k token 的长 prompt 冷启动要 131 秒,这个数字在 agent 场景里相当致命,每轮对话都要重新吃一遍上下文的话根本没法用。
好在 llama.cpp 的 prompt cache 默认就开着,效果极好:同一个 prompt 重发,131 秒直接变成 0.38 秒(11623 / 11627 命中缓存)。多轮 agent 循环里,这个差距的分量远大于解码那 35%。
所以纯对话、单轮生成我会用 MLX。多轮 agent 还是 llama.cpp 划算。
运行本地编码任务
老金用来测试的任务是让它写一个 AI 冥想应用的落地页。完整 prompt 如下:
请作为一名前端专家,为一款名为 'Aura' 的 AI 冥想应用
编写一个现代、极简风格的 Landing Page(落地页)。

要求:
只输出一个单一的 index.html 文件,将 CSS 写在 <style> 标签内。
不要使用任何外部图片,可以使用 CSS 渐变、Emoji 或简单的 SVG 作为占位符。
页面包含:一个带有渐变文字的 Hero Section(主视区)、
一个包含三个特点的 Grid 布局功能区、以及一个底部的邮件订阅表单。
必须是纯响应式设计,在手机端和 PC 端都有完美的内边距和排版。
使用柔和的莫兰迪色系。
每条约束都在防一个具体的崩法
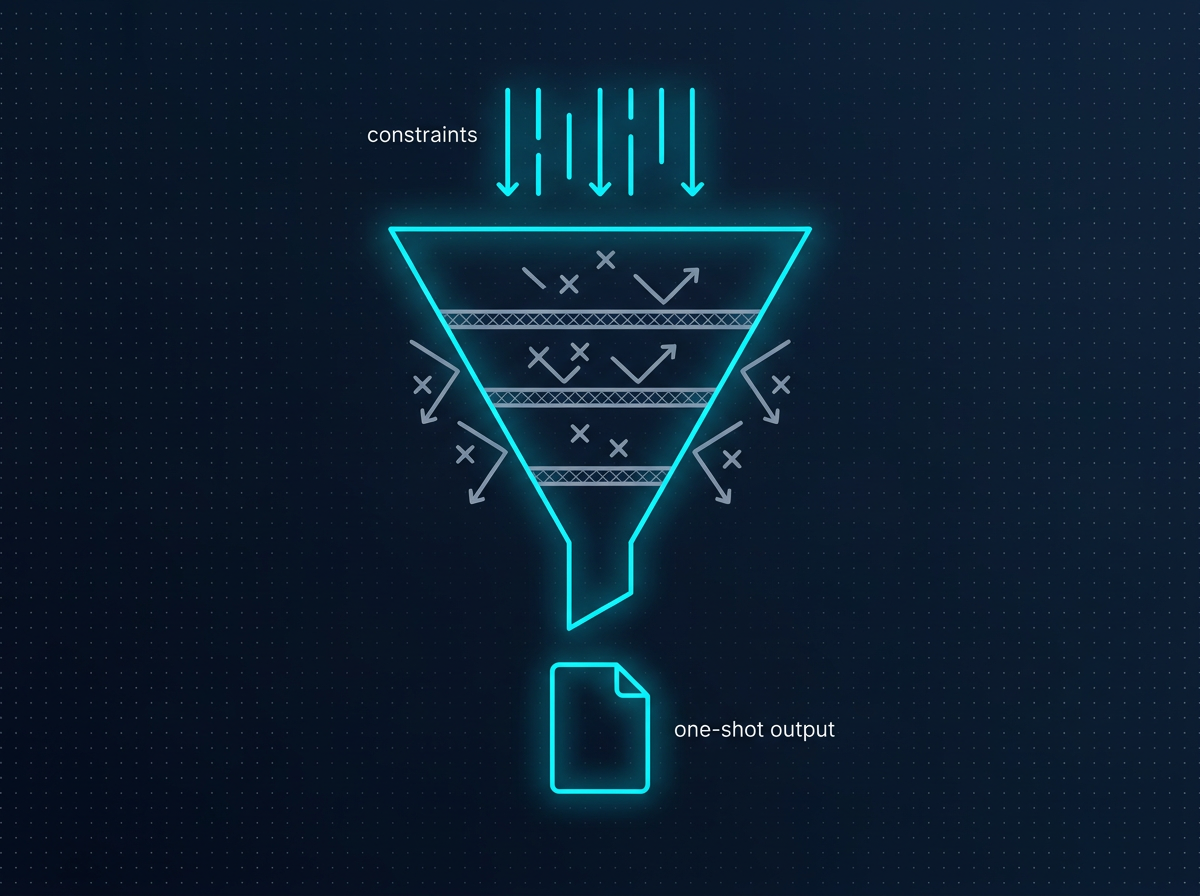
这个 prompt 看起来平平无奇,但每条都对应本地模型的一种典型故障。
「作为一名前端专家」。对 27B 这个量级,角色设定的实际收益比对旗舰模型明显得多,它会改变默认的代码风格和细节密度。
「只输出一个单一的 index.html,CSS 写在 style 标签内」防的是跨文件协调,这是本地模型最容易崩的地方:生成 HTML 时引用了 style.css,写 CSS 时类名又对不上。单文件把这个失败模式整个删掉。
「不要使用任何外部图片」切断幻觉 URL。不加这条,模型几乎必然编造 unsplash.com/photo-xxx 之类根本不存在的图片地址,页面一打开全是碎图。同时要给出替代方案(渐变 / Emoji / SVG),否则它会卡住或留空白。
「Hero + 三特点 Grid + 邮件订阅表单」把开放式创作变成填空。明确的区块清单让模型不需要自己做信息架构决策,而这恰恰是小模型最不稳定的部分。
「纯响应式,手机端和 PC 端都有完美的内边距」,注意它同时点名了两种设备。只说"响应式"的话,模型往往只写一个 @media 就交差。
「柔和的莫兰迪色系」是唯一的审美约束,但极其具体。"好看"、"现代"这类词对模型没有信息量;"莫兰迪"是一个有明确色彩特征的专有名词,直接对应到低饱和度调色板。
核心思路 描述得详细没什么用,得把审美要求翻译成结构要求。"现代极简"你没法验证。"单文件 / 无外部资源 / 三个指定区块 / 双端响应式 / 莫兰迪"这五条,每一条都能用眼睛或脚本当场判定。
思考等级要开
这次运行老金把 pi 的 thinking level 设成了 medium,模型产出了 18,883 字符的思考过程,占掉了 20 分钟里相当大一部分。但这部分投入值得。落地页这类任务需要模型先把配色、断点、区块结构想清楚再动笔,否则写到一半改主意,以 11 tok/s 的速度重来一次代价太高。
模型自己写了个校验脚本
有个细节老金觉得比页面本身更有意思。写完 index.html 之后,模型没有直接收工,而是主动调用 bash 工具,现场写了一段 Python HTMLParser 脚本来检查标签闭合:
# 模型自发执行
python3 - <<'EOF'
from html.parser import HTMLParser
...
EOF
# → errors: none / unclosed: none
同样的模型放在纯聊天界面里只能吐一段文本,放进能执行命令的 agent 框架,它就会开始自我验证。功劳更多在 harness。这次运行总共三轮工具调用:写文件 → 校验结构 → 输出设计说明。
结果验收:20 分 07 秒之后
563 行、17 KB 的单文件 HTML,零外部依赖。
最终效果如下:
命中的部分
- 渐变文字用
background-clip: text实现,落在标题的关键词上而非整句 - 功能区用
repeat(auto-fit, minmax(min(260px, 100%), 1fr)),是真流体网格,不是三个写死的断点 - 间距和字号大量使用
clamp(),在断点之间也能平滑过渡 - 外部资源引用数:0
还有两处是我没要求、但它自己加上的:9 处 aria / label 无障碍标注,包括给订阅输入框配了视觉隐藏的 label;以及 prefers-reduced-motion 支持,呼吸光晕动画会对晕动敏感用户自动关闭。
没做好的部分
中文标题的换行处理不到位。桌面端 Hero 的"交还给此刻的呼吸"里,"吸"字被孤零零挤到了第三行;移动端"安静的窗"也有同样的孤字问题。模型对 CJK 断行规则没有概念,这需要一句追加 prompt 来修:
给所有标题加上 text-wrap: balance,
并确保渐变关键词不被拆到两行。
所以本地 27B 到底能干什么
我会交给它的活儿:单文件、结构明确的产出,落地页、配置文件、脚本这一类;有客观验收标准的任务;涉及敏感代码、不能出网的场景。还有批量的、不赶时间的重复劳动。
暂时别指望的:
- 需要快速多轮试错的探索型任务,一轮 20 分钟
- 跨文件的大型重构
- 需要最新框架知识的工作
- 你盯着屏幕等结果的交互式编码
11 tok/s 很慢,但它可以整晚不停地跑,不计费,不上传任何东西。派给它那些"结果明确、就是懒得写"的活儿,体验会好很多。