如何用 Astra 为独立开发找项目
用 ChatGPT 6 Astra 写了个机会研究工具:把有收入的软件业务收进来,让模型拆出客户为什么付费、哪些功能能砍、最小 MVP 长什么样。附完整技术栈、CSV/HTML/URL 三种数据入口,以及 Zod 结构化输出和 Prisma 事务写入的实现细节。
ChatGPT 6 Astra 出来之后,我拿它写了个小工具,给自己找独立开发的项目用。
思路不复杂:把那些已经有收入的软件业务收集起来,交给模型拆一遍——用户真正掏钱买的是什么,现有产品里哪些功能其实可以删掉,还有哪些痛点没人解决,砍到最小能做成什么样的 MVP,如果自己下场,差异化的点又在哪。
界面做成什么样
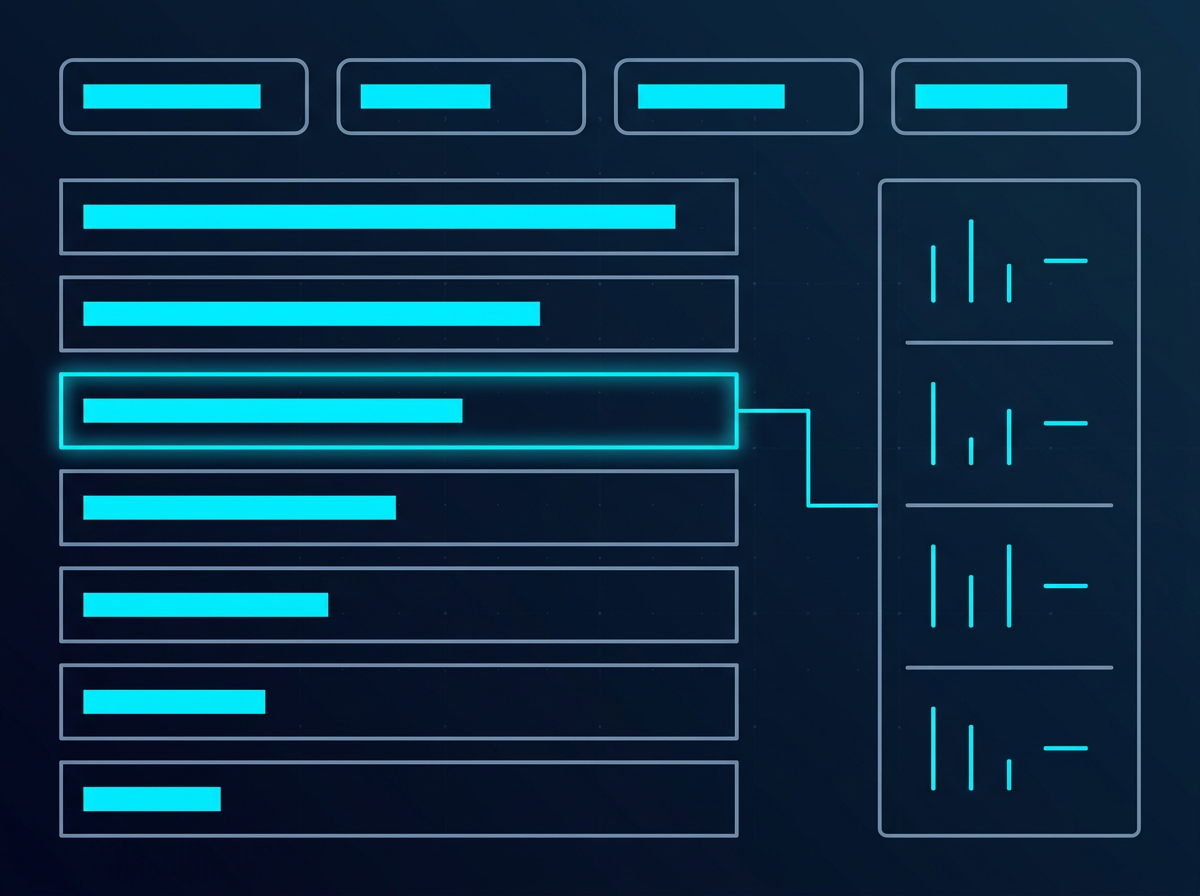
首页是一个列表,收进来的都是已经过市场验证的业务,可以按收入和分析状态筛,点进去看完整的拆解报告。
我刻意没做成营销落地页的样子。收入、利润率、售价、分析状态都用明确的数据层级排开,方便横着扫一眼做比较。产品本身就是"从复杂业务里找更小的产品",界面就没必要再堆装饰——留白、清晰的边界、每块只讲一件事,把结论放在最显眼的位置。
顶部数据条只放四个全局指标:机会数量、AI 分析覆盖率、总月收入、总月利润。看的是当前样本够不够大、整体商业质量如何。
报告本身分四块:
- What customers need:客户为什么付费。
- Where the market still hurts:现有方案仍未解决的问题。
- The MVP worth shipping:最值得构建的精简功能。
- What to cut:不该进入第一个版本的复杂功能。
每条结论都带序号。AI 生成的内容往往偏长,有编号好扫得多,讨论的时候也能直接指第几条。
技术原理
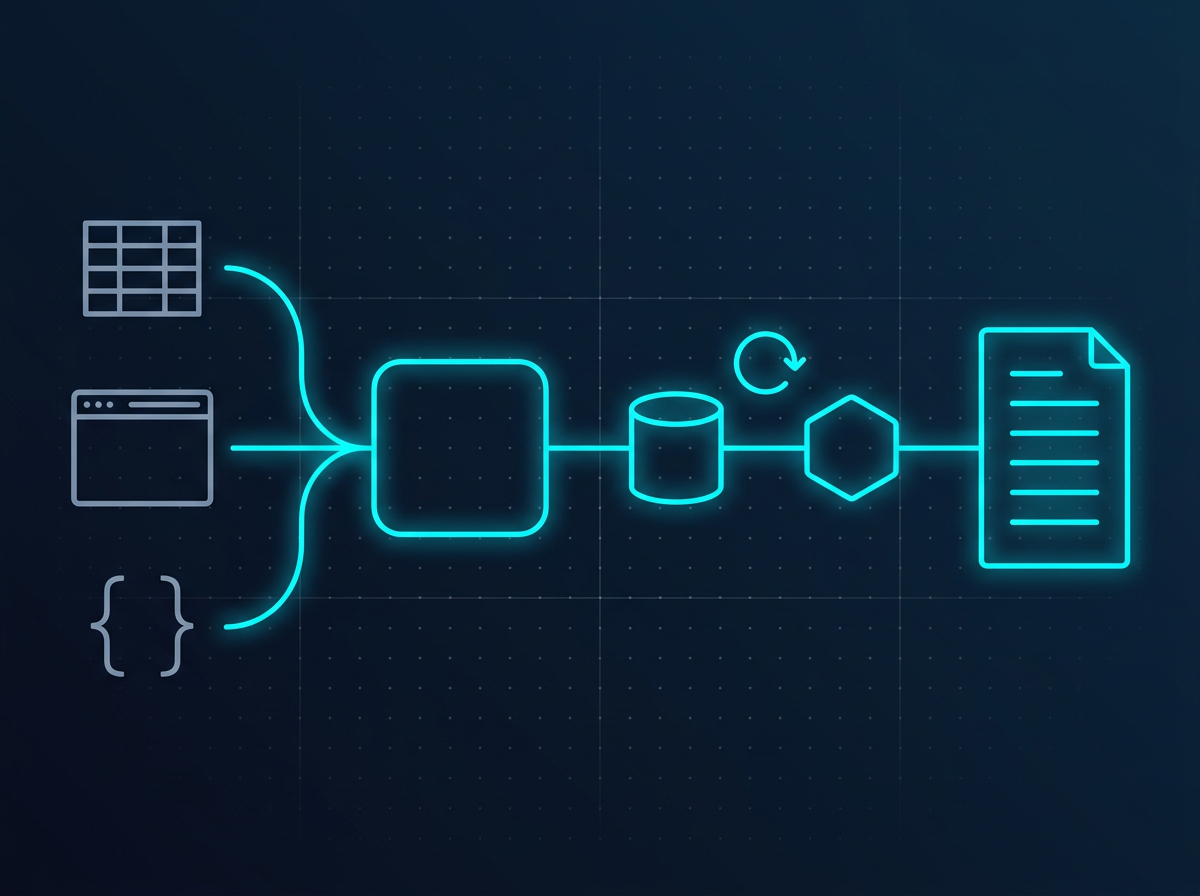
整条链路是这么走的:
- 从 CSV、浏览器保存的 HTML 或者 API 接收软件业务信息。
- 把不同来源的数据统一转成
ListingInput。 - 按来源 URL 去重,写入数据库。
- 把待处理的项目丢给大语言模型,用 Zod 约束返回结构。
- 分析报告和处理状态原子化写入数据库。
- 页面走服务端渲染,提供筛选、概览和报告阅读。
技术栈
| 层级 | 技术 | 作用 |
|---|---|---|
| Web 框架 | Next.js 16 App Router | 路由、服务端渲染、API Route |
| UI | React 19 | 页面与组件结构 |
| 样式 | Tailwind CSS 4 + Global CSS | 基础样式能力、设计令牌和响应式布局 |
| ORM | Prisma ORM 7 | 数据模型、类型生成和数据库访问 |
| 数据库驱动 | pg / better-sqlite3 | PostgreSQL 与 SQLite 连接 |
| AI | Vercel AI SDK | 调用模型并生成结构化结果 |
| 数据校验 | Zod | 校验 AI 返回的数据结构 |
| HTML 解析 | Cheerio | 从保存的网页中提取业务信息 |
| CSV 解析 | csv-parse | 将 CSV 转换为标准数据 |
| 部署 | Vercel | Next.js 托管与定时任务 |
| 语言 | TypeScript | 静态类型检查 |
统一输入模型
所有数据入口最终都会转成 ListingInput:
type ListingInput = {
  sourceUrl: string;
  title: string;
  category?: string;
  askingPrice?: number;
  monthlyRevenue?: number;
  monthlyProfit?: number;
  description: string;
  pricingInfo?: string;
  reviewsSnippet?: string;
  rawData?: string;
};
这样"数据从哪来"和"数据怎么存"就不互相牵扯了。以后要接浏览器插件、第三方采集服务或者别的交易平台,只要能吐出同样的结构就行。
CSV 导入
npm run import:csv -- path/to/file.csv
scripts/import-csv.ts 读文件,parseListingsCsv() 按表头逐行解析,检查 sourceUrl、title、description 三个必填字段,把金额里的货币符号和千分位清掉,最后交给统一入库函数。
CSV 是目前最稳的入口,它不依赖目标网站的页面结构,也不用管人家的反爬策略。
HTML 导入
npm run import:html -- path/to/html-directory
解析分两级。先找页面里的 application/json 或 __NEXT_DATA__,在里面递归找同时带标题、价格或收入特征的对象;实在找不到结构化数据,才退回 DOM、Meta 标签和正则去抠。
递归最多下六层,提取到的原始对象截断后存进 rawData,解析出错的时候好排查。
网页结构随时会变,所以这套解析是启发式的,别当成稳定 API 用。
URL 直接抓取
npm run fetch:listings -- urls.txt
逐行读 URL,普通 HTTP 请求拿 HTML,每次请求之间等三秒,然后交给上面那个解析器,最后汇总成功和失败的清单。
它不会去绕验证码、浏览器挑战、代理限制或设备指纹。碰到 403 就老实换 CSV 或者浏览器保存的 HTML。
AI 分析
单条项目分析
analyzeListing() 把项目名称和类别、售价、月收入月利润、原始业务描述、定价信息、用户评价拼进提示词。
结构化输出
输出这块直接用:
Output.object({ schema: ReportSchema })
让模型按 Zod 定义好的结构返回:
{
  summary: string;
  coreNeeds: string[];
  redundantFeatures: string[];
  unmetPainPoints: string[];
  suggestedMvpFeatures: string[];
  differentiation: string;
}
字段名稳定,数组和字符串类型明确,页面就不用去猜自然语言的格式。不符合 Schema 的输出直接算失败。
批量分析
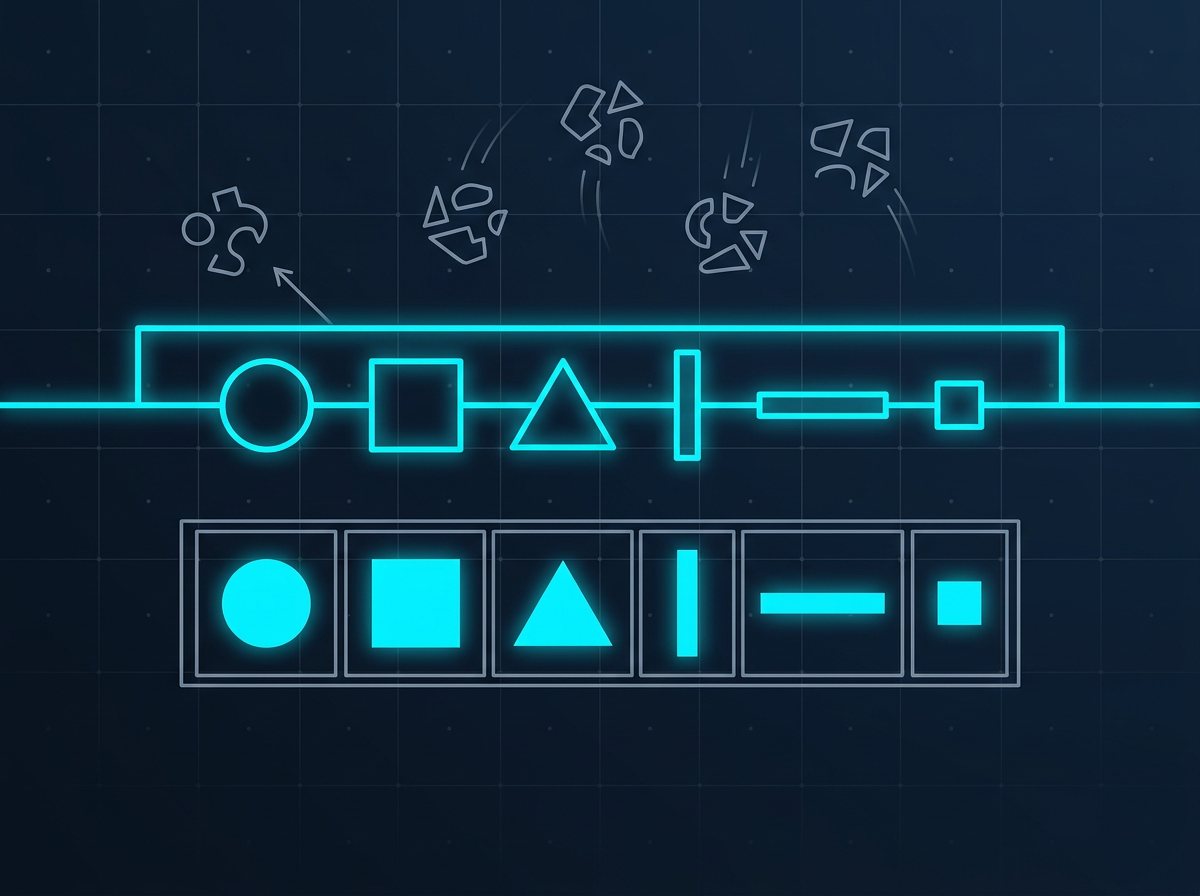
analyzePendingListings(limit) 捞出状态是 PENDING 的项目,一条一条处理。
单条分析成功后,用 Prisma 事务同时创建或更新 Report、把 Listing.status 改成 ANALYZED。两件事都成功事务才提交,否则就会出现报告已经生成但状态没更新(或者反过来)的中间状态。模型调用、结构校验、数据库写入任何一步挂了,状态就置成 FAILED。
现在是串行跑的。逻辑简单、调用速率好控制,代价是数据一多就慢。后面想加受控并发、重试次数和错误原因字段。
现在怎么用
整个工程都是 Astra 写的,但运行时不用 Astra 模型(太贵),一般用 GPT 5.6 Terra 分析效果也够用。眼下主要拿它分析 AppStore 上的产品,从里面挑能搬到鸿蒙端做的 App。