Agent 跑了两小时,结果是零——它是怎么卡进 Doom Loop 的
Agent 跑了几小时但任务进度是 0,这就是 Doom Loop。讲清四种成因、工业级断路器和检测器怎么破,以及为什么模型外面必须补五层控制——架构问题,不是模型问题。
你让 Agent 帮你做一件事。
它开始工作,终端一直在滚:
Thinking...
Acting...
Thinking...
Acting...
两小时后,你去看结果。
任务进度:0。
它没有卡死,没有报错,甚至还在"努力"。但它什么都没做完。
这就是 Doom Loop——Agent 持续执行,却始终没有有效进展的状态。
跟普通的死循环不一样。死循环 CPU 跑满、进程僵住,监视器一眼就能看出来。Doom Loop 不会:它每一步都按 ReAct 的逻辑跑,工具在调用,模型在思考,token 在烧,日志一直在滚——指标都正常,只是这些动作合起来没在推进任务。
Agent 自己也感觉不到。每一轮"思考 → 行动 → 观察"对它来说都符合训练时见过的模式。要等到你回来看进度、或者月底拿到 LLM 账单,才会发现它陷在原地。
Doom Loop 是怎么来的
Agent 的底层是 ReAct 循环:思考 → 行动 → 观察 → 再思考。
循环本身没问题,问题在于有四类场景会让它原地打转。
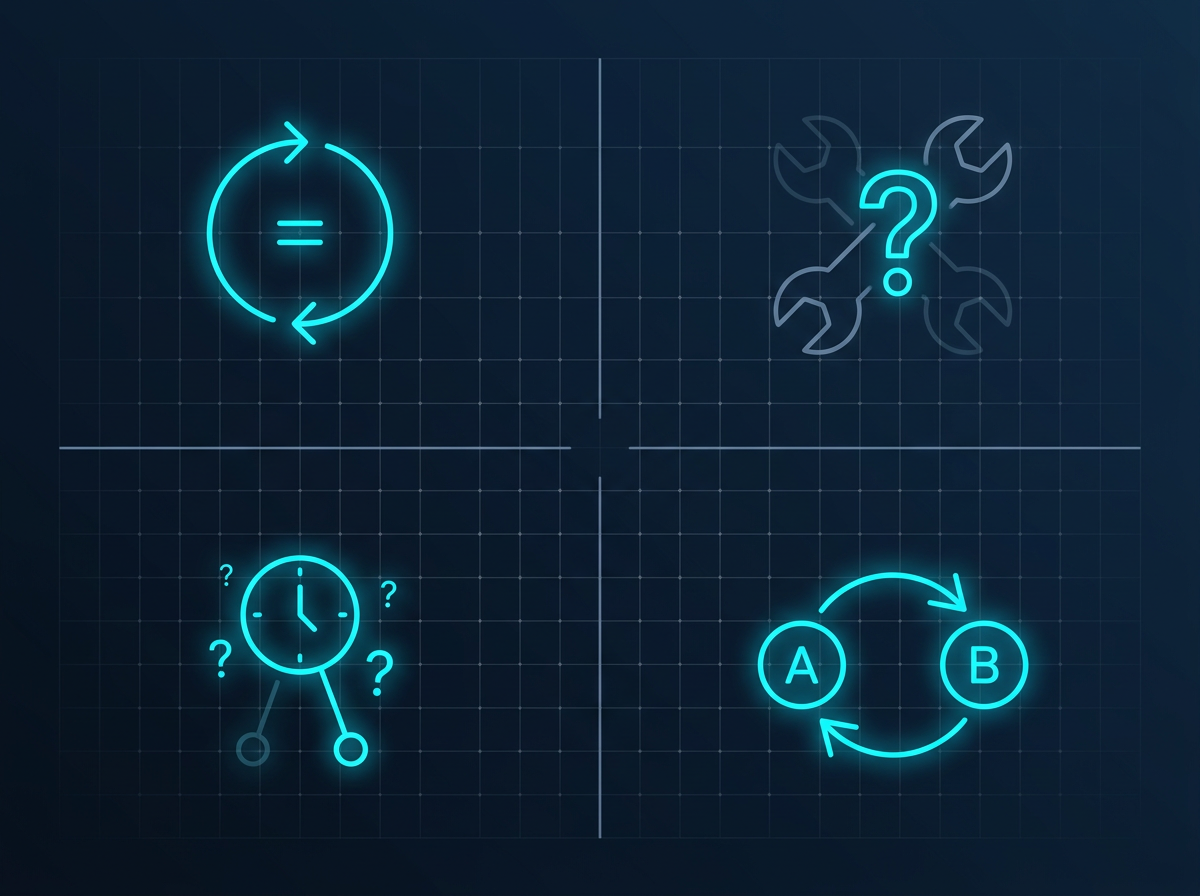
1. 相同调用,相同结果
Agent 用完全相同的参数反复调用同一个工具,每次得到一样的返回,却始终提取不到新信息。模型下一轮还是做出相同决策,严格意义上的确定性死循环。
2. 调用根本不存在的工具
模型幻觉出一个工具名,每次调用都返回"工具不存在",但它把这个当成"可能暂时不可用"继续重试。这类错误永远无法通过重试解决。
3. 轮询工具卡死
Agent 反复调用状态查询工具,每次得到 { status: "running" },因为它在等一个永远不会发生的事件——被轮询的进程已经僵死了。Agent 不知道该何时放弃。
4. 两个操作交替振荡(Ping-Pong)
读文件 → 文件不存在 → 创建文件 → 权限不足 → 读文件…… A→B→A→B 无限交替,每一侧都在"工作",整体任务毫无推进。
四种场景的共同点:工具一直在调用,但每一轮都没有产出新信息。
工业级 Agent 怎么破
以 OpenClaw(Claude Code 同类架构)为例,它构建了两道防线。
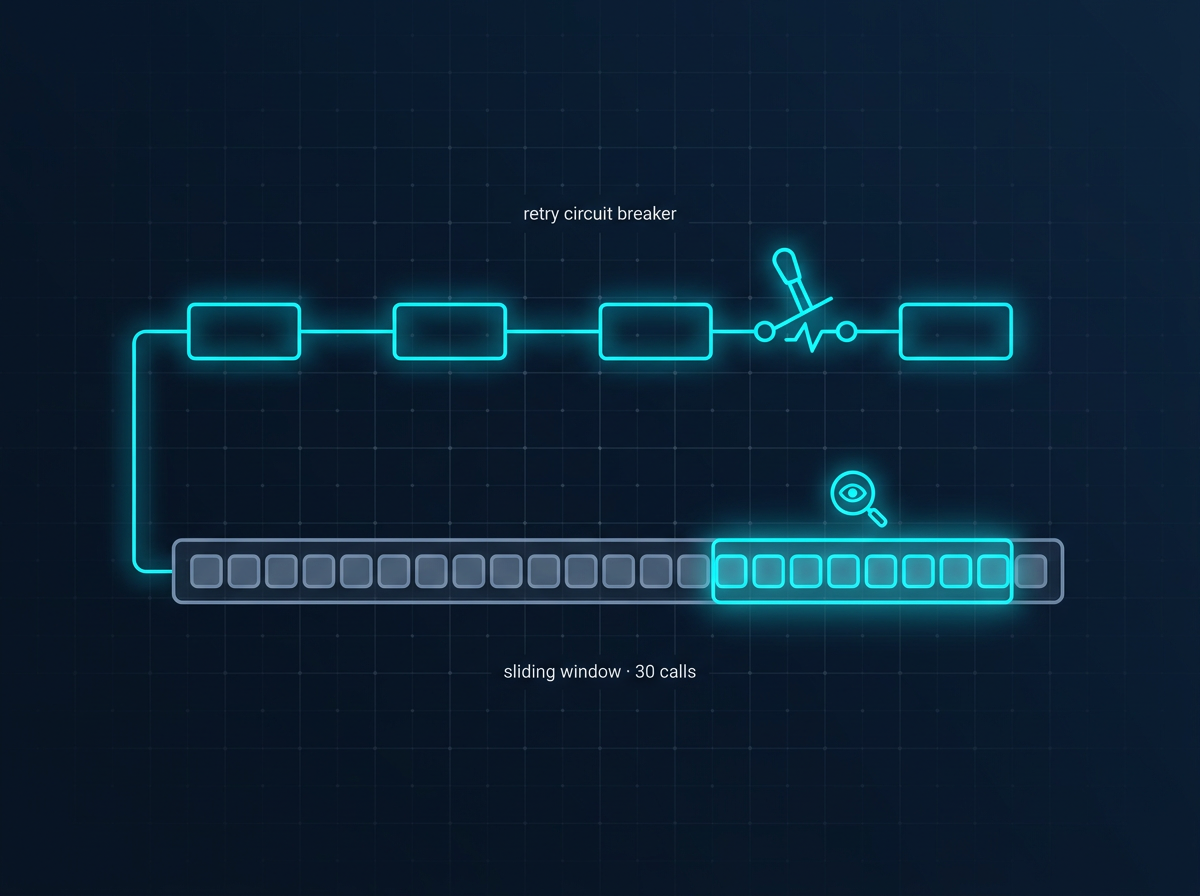
第一道:重试端断路器
容错重试本身必须有上限,否则它会变成另一种 Doom Loop。
OpenClaw 的做法:
- 上下文压缩最多触发 3 次,防止无限压缩导致信息损失
- 总重试次数硬限 32–160 次(根据候选模型数量动态计算),所有错误路径共用同一个计数器,超出即终止
const MAX_OVERFLOW_COMPACTION_ATTEMPTS = 3;

if (runLoopIterations >= MAX_RUN_LOOP_ITERATIONS) {
  // 超出重试限制,终止整个运行
}
第二道:工具循环检测
基础原语:哈希指纹 + 滑动窗口。
每次工具调用都生成一个指纹——工具名 + 参数哈希,保留最近 30 条历史,在这个窗口里检测异常模式。
两级告警:
warning(≥10 次):向 Agent 返回提示,给它一次自主纠正的机会critical(≥20 次):忽略 Agent 的判断,直接终止会话
这比硬断更符合 Agent 的自主决策模式。
四种检测器:
- 未知工具重复——同一个不存在的工具被调 ≥10 次,直接 critical,不经过 warning
- 轮询无进展——相同结果出现 ≥10 次给 warning 提示操作方向,≥20 次终止
- 通用重复调用——同参数 + 同结果 ≥20 次,critical 终止
- Ping-Pong 振荡——A-B-A-B ≥20 次且两侧结果都无变化,critical 终止
还有一个容易被忽视的场景:上下文压缩完成后,Agent 会继续执行同样的工具调用,再次卡死,再次压缩,周而复始。压缩并没有打破循环,只是把崩溃推后。
OpenClaw 的解法是,压缩成功后立刻开启一个 3 次机会的观测窗口——如果窗口内某个工具以完全相同的参数产出完全相同的结果,直接终止会话。
if (matches.length >= state.windowSize) {
  // 压缩没能打破循环,直接终止
  return {
    shouldAbort: true,
    detector: "compaction_loop_persisted",
    message: "CRITICAL: compaction did not break the loop. Aborting...",
  };
}
Doom Loop 只是 Agent 失控里最容易被看见的那一种
一张 Claude 工程师分享的图,把长任务 Agent 最常见的三件事说得很准:
带不住状态,估不准工作量,评不好自己的输出。
这三件事一起出现,就是长任务最常见的失控链路——状态、计划、验证一起垮。
状态。随着对话变长、工具调用变多、错误信息堆进来,context 里的噪声开始变多。到了后半程,Agent 还在继续工作,但已经不像在沿着原来的任务前进,更像是在当前上下文里找一个看起来合理的出口。
规划。你让它"改一下文档生成流程",它可能把整个内容系统都扫一遍。你让它"做一个可用 demo",它可能只搭一个 UI 空壳。前几步看起来很顺,等 context 用掉一大半,真正难的部分还没碰,后半程开始收缩范围,最后用"核心功能已完成"收尾。
验证。接口能返回 200,Agent 就说功能可用。它没有点过页面,没有走过真实用户路径,没有检查数据是否真的写入。Agent 很擅长给自己的工作做一个体面收尾,但这种收尾经常只是在替一次很浅的验证包装结论。
模型外面那五层
要解决上面这三件事,模型外面得有五层东西。
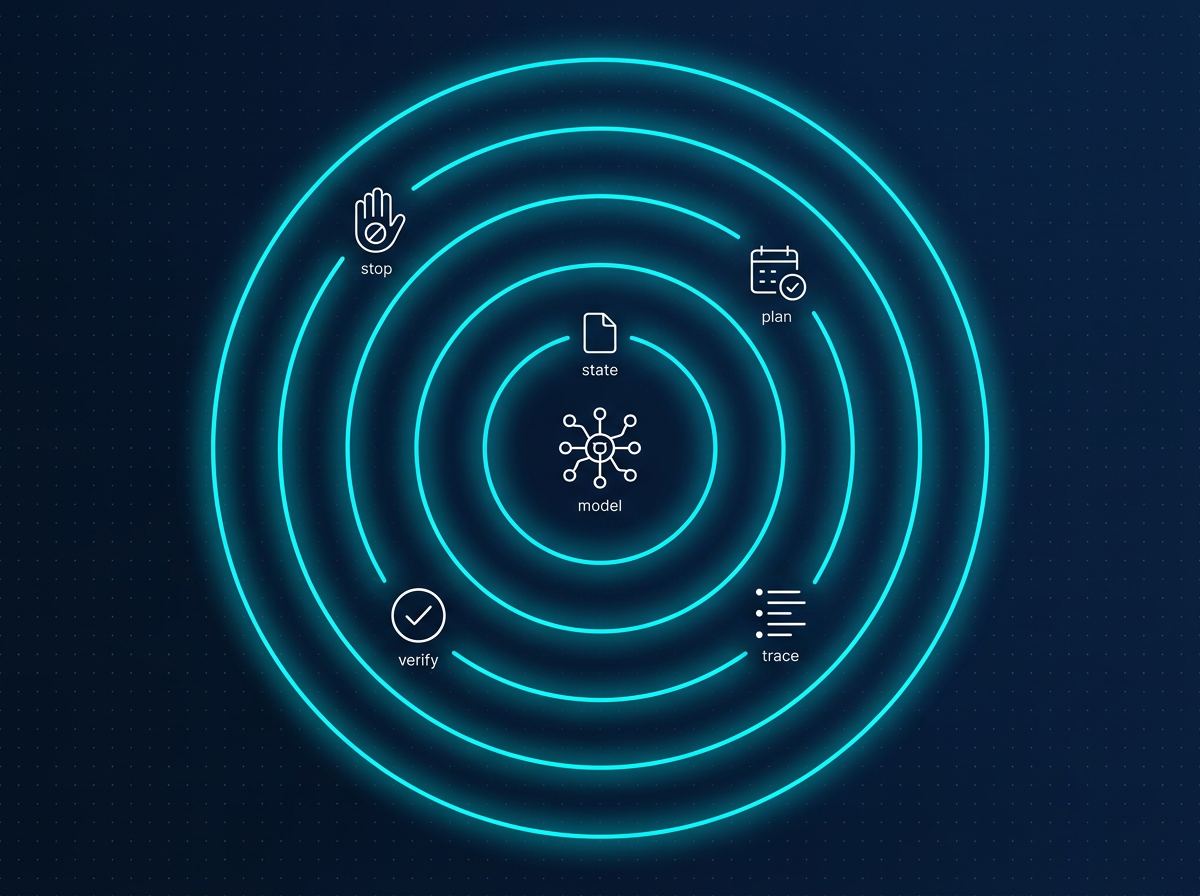
1. 状态。 progress.md 或者数据库,任务目标、当前进度、决策记录、验证结果都落这里。可读回、可续跑、可审计——对话断了,现场还在。
2. 规划。 不是 checklist,是调度单。当前阶段做什么、输入输出是什么、用什么验证、最多跑多久、失败几次后停止、哪些操作需要人工确认。好的规划单是给 Agent 限自由度,不是给它列选项。
3. 执行 trace。 每次工具调用的输出必须落盘。只在上下文里闪一下的调用结果,会被后续噪声淹没。
4. 验证。 三档堆在一起:机器验证(测试 / lint / build / schema validation)、环境验证(Web 应用要用浏览器点,不只 curl)、独立评价(生成者和评价者分开,Evaluator 必须有权判 FAIL)。
5. 硬停止。 任务范围扩大、预算逼近上限、验证连续失败、操作涉及删除 / 发布 / 生产数据——这几条要写死,不能靠模型临场判断。
怎么判断一个 Agent 工作流靠不靠谱
不看模型名,我会先扫这几样。
状态有没有外部存储——任务进度、决策记录是不是只活在 context 里。
规划有没有阶段边界和验收标准,还是给个目标让它一路跑。
工具调用结果进没进可审计的 trace。
谁来判完成——独立评价机制比 Agent 自己说"可以了"靠谱多了。
什么时候它必须停——预算上限、连续失败、动到生产数据,这些要写死。
任何一项答不清,模型越强,跑偏时造成的动静越大。
Doom Loop 是架构问题,不是模型问题。断路器和循环检测能挡掉最坏的情况,但让长任务真正可靠,还得靠上面这五层一起在线。
如果你正在做长任务的 Agent,回头看上面那几条,哪一项答不上来就先补哪一层。换更强的模型解决不了它们。
最后留个钩子。开头那四种 Doom Loop,你的 Agent 最近一次跑飞,是栽在哪一种上的?
评论区扣个数字就行:
1 相同调用相同结果 / 2 调用幻觉出来的工具 / 3 轮询一个死掉的进程 / 4 两个操作 Ping-Pong 来回振荡
我赌 3 最多——等一个永远不会来的状态,是我自己被坑得最惨的一次。也欢迎补个 5:你踩过、但上面四种都没覆盖的卡法。