省 token 省过头,一次重试就全赔回去了
省 token 省到任务失败、重跑一遍,前面省的全赔进去。拆解 Claude Code 一个任务的四个成本变量:回合数、缓存、输出与思考、模型;讲清 effort 怎么调、何时降级或升到 Fable 5.1、别打断缓存、/compact 何时回本,以及用 /usage 量出你自己的数。
每一种省 token 的方式,都可能让你完不成任务。而一次重试的花费,比这些省下来的都多。
你要的是把功能做完。省 token 省到任务失败、重跑一遍,前面省的那点全赔进去,还要倒贴。
钱花在哪、哪些设置真正影响账单、怎么量出你自己的数。
先记住 Opus 5.5 的价格
每百万 token:
| 项目 | Opus 5 | Opus 5.5 | 降幅 |
|---|---|---|---|
| 输入 | $5 | $4 | -20% |
| 输出 | $25 | $20 | -20% |
| 缓存读取 | $0.50 | $0.20 | -60% |
注意最后一行,缓存读取从输入价的 1/10 降到了 1/20。
再记一个比例:一个输出 token 的价格,是一次缓存读取的 100 倍。
一个任务的钱从哪来
Claude Code 里的一个任务就是一个循环:模型读对话 → 调工具 → 读结果 → 再来一轮,直到干完。每一轮都要把到目前为止的整段对话重发一遍。
能影响成本的有四个变量。
回合数
官方举了个例子。一个任务,上下文从 20K 涨到 120K,跑了 40 轮,平均每轮发 70K,总共 2.8M 输入 token。对话本身从没超过 120K,但你付的是 2.8M。
- 40 轮完成:输入成本约 $1.62
- 25 轮完成:输入成本约 $1.02
同一个任务,少 15 轮,省 37%。
想少跑几轮,最有效的是给模型一个检查自己的办法:一个能跑的测试、一次构建、一个调接口的脚本。它能自己验证,就能早点发现错,不用等写完了你看、你说不对、它再改。
缓存
还是那 2.8M 输入:
- 没缓存:$11.20
- 90% 命中:$1.62
- 96% 命中:$0.99
差了十倍,没有别的设置能影响这么大。怎么别把它打断,后面单独讲。
输出,包括你看不见的思考
一个典型任务 60K 输出 token,花 $1.20,相当于从缓存里读 6M token。
thinking 按输出计费。Claude Code 只给你看摘要,但它想的每个字你都付钱,所以 effort 对账单影响才这么大。
模型
决定每个 token 的单价。这个好理解,下面讲怎么选。
换模型之前,先调 effort
上一篇我写过"简单活别用 Opus,切 Sonnet、Haiku",但其实有更细致的做法。
先看 effort。Opus 5.5 有四档:low、medium、high、xhigh,外加单次会话用的 max。
/effort medium      # 设置档位
/effort status      # 查看当前档位
官方的用法:
- medium:范围明确的日常活,从这里起步
- high:medium 卡住了再升
- low:机械活,比如重命名、在多个文件里套一个已知模式
high 值不值,可以算一笔账。假设 high 在一个任务里多想了 20K token,按输出价是 $0.40。而一个 10 轮的重试循环,100K 缓存上下文,总共 10K 输出,成本也差不多是 $0.40。
也就是说,high 只要帮你省掉一次重试就回本了。medium 本来就能一次搞定的活,开 high 就是白花钱。
什么时候该升档?看"只修了一层"
官方举的例子很典型:API handler 里一个字段改名了。
medium 下,模型改了 handler,handler 的测试也过了,但客户端还在发旧字段。你要它做的它确实做了,只是没读得够远,没找到第二个调用方。
high 下,它会在动手前多花几轮读调用点,一次把两层都改了。
但官方紧接着补了一句:升档之前,先看看它有没有办法检查自己。如果有一个会经过客户端的测试,旧字段在写入那一轮就会让测试挂掉,medium 也能发现。一次测试只花一轮和它的输出,更高的 effort 却是每一轮都在加思考。
所以顺序是:
加一个检查手段 → 升 effort → 换更大的模型
降级只用来"查",别用来"写"
降级到 Sonnet 或 Haiku,用于查询,不要用来写代码。
- 适合小模型:搜索、总结的子 agent,读日志、读测试输出,"这个函数在哪定义的"
- 跨多个文件的机械编辑:留在 Opus 5.5,把 effort 调到 low
编辑应该留在写其余代码的那个模型上。小模型要是误读了搜索结果,主模型就会去找错的文件,绕的这段路还是主模型付钱。所以小模型只干错了容易发现的活:找文件、跑测试、读日志。
把子 agent 设成小模型,两种方式:
# 在子 agent 定义里单独指定
model: haiku
# 或者一次性设置所有子 agent
export CLAUDE_CODE_SUBAGENT_MODEL=sonnet
子 agent 定义里写了模型的,会覆盖环境变量。什么都没写的,默认跑在你的主模型上,价格也跟着主模型走——这一点很多人没注意。
什么时候升到 Fable 5.1
Fable 5.1 每百万输入 $10、输出 $50,是 Opus 5.5 的两倍半。但它的缓存读取只要 $0.25,只比 Opus 5.5 贵 25%。所以长时间、缓存密集的运行里两者差价最小,大量输出的任务里差价最大。
官方给的规则很好记:Opus 5.5 在 high 下两次撞到同一个问题,就切 Fable 5.1,解决完切回来。别等到第三次失败。
适合 Fable 的场景:长时间无人值守的运行、代码库里没有现成模式可抄的问题、要协调多个子 agent 的大改动。
切的时候注意两点:
- 在自然断点切。新模型从空缓存开始,第一轮要为整段对话付写入价。先
/compact,或者写个简短计划开新会话。 /model会把你的选择存成新会话的默认值,难的部分做完记得切回来。
别亲手打断你的缓存
缓存存的是前缀,只能复用"从头开始和上一次请求一致"的那部分。改动了早期内容,后面就全部失效。
以下操作会触发缓存重写:
- 暂停超过缓存有效期
- 改 effort 或 thinking 设置
- 连接或断开 MCP server
- 切换模型
- 对话被压缩
第二条单独说一下:改 effort 会清掉缓存。所以 effort 也要在断点改,别一个问题问到一半来回拨。
5 分钟还是 1 小时
缓存有效期取决于你怎么付费:
- Claude 订阅:1 小时
- API key 或云厂商:默认 5 分钟
- 订阅在用额度积分时:也降到 5 分钟
120K 上下文在 Opus 5.5 上,一次缓存读取约 $0.02,一次 5 分钟缓存写入约 $0.60,一次写入顶 25 次读取。用 API key 的时候,你起身倒杯水、六分钟后回来,下一轮就从 $0.02 变成 $0.60。
会话开始时把模型、effort、MCP 都设好,干活期间别动。
/compact 什么时候回本
在 150K 上下文时压缩一次,大约花 $0.25(读一遍、写几千 token 摘要、在短上下文上重建缓存),之后每轮省约 $0.025 的读取。大约 10 轮回本,所以快干完了就别压了,压了反而亏。
摘要还会丢细节。调试到一半压缩,可能正好丢掉唯一关键的那行日志。压的时候告诉它留什么:
/compact keep the failing test names and the schema change
/clear 是免费的,转去做不相关的事就用它。
计量你自己的数
官方全文最后一条要点是加了粗的:在每个模型上跑一个真实任务,对比 /usage。你自己的数字才值得信。
任务结束时跑:
/usage
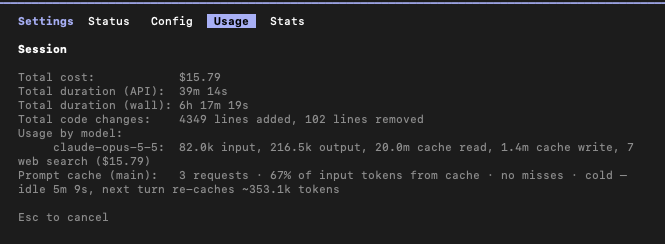
看三个比例:
- 缓存占比。长会话应该很高。如果低,查查有没有长时间停顿、中途改了 effort 或模型、中途接了 MCP。
- 输出和输入的比值。小改动却有一大堆输出,通常是 effort 开太高了,或者模型在反复重试。
- 总输入和对话大小的比值。总输入是对话大小的很多倍,说明跑了太多轮,值得翻回去看看在哪兜圈子。
参考线:官方给的企业平均值是每个开发者每个活跃日约 $13,90% 的人不超过 $30。哪个会话明显高出你平时的水平,就翻出来看看是哪一步多花了。