请收藏,Claude Code 省 token 手册
大模型接口是无状态的,每按一次回车,整段历史都会被重新打包发一遍,钱主要烧在这里。整理了我平常在用的省 token 手段:一个任务一个对话、让它精确读文件、大范围检索交给子 agent、砍掉常驻的 MCP 和 CLAUDE.md、简单活切便宜模型、管住输出长度。
无论是 Claude Code,还是 ChatGPT,模型迭代速度越来越快,但新模型也有一个共同点——贵。Fable 5.1 定价为每百万输入 token 10 美元、每百万输出 token 50 美元。如果用来跑长时任务,美刀哗啦啦就流走了。
但其实是有省 token 的诀窍,Claude 官方也推荐大家不要浪费,采用一些省 token 的手段。这里给大家总结了一些我平常用的省 token 技巧,汇集成本手册。
首先搞明白:钱是在哪一步烧的
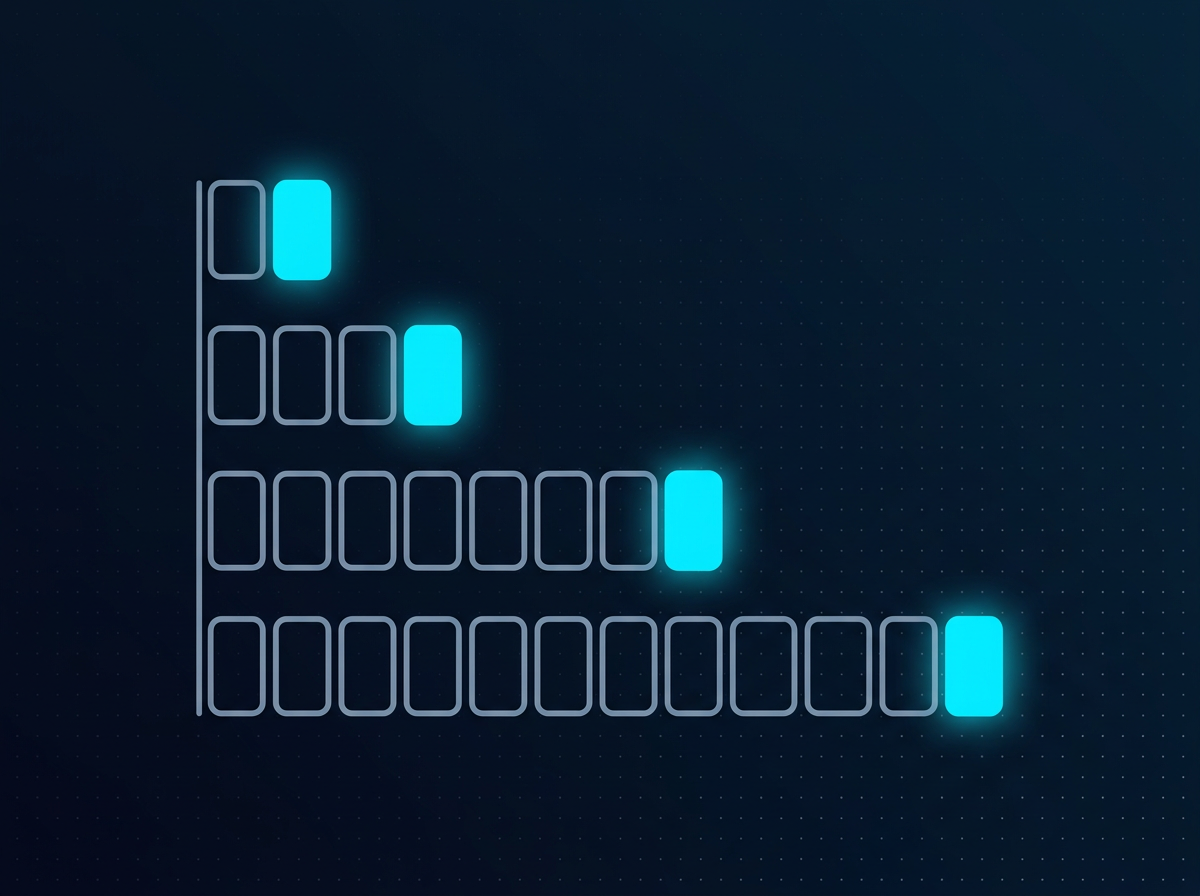
大模型的接口是无状态的,它不记得你上一句说过啥。每次你按回车,客户端都会把从开头到现在的整段对话重新打包,连同你新问的这一句一起发过去。
你付费的对象不是你刚问的那句话,是到目前为止的整段对话,每一轮重付一次。
有人会说不是有缓存吗。对,prompt caching 会把没变过的前缀按大约 1/10 的价格算,这确实省很多。但它有三个边界你必须知道。
默认只活 5 分钟。你去开了个会、吃了个饭,回来接着发,缓存早过期了,整段历史按原价重新烧一遍。
改动早期内容,后面全部失效。你回头编辑了前面某条,或者中途切了模型,缓存就从那一刀之后全断。
还有一条最容易被忽略:历史只增不减。就算命中缓存,那段历史也在一轮一轮变长,1/10 的价乘上一个越来越大的数,照样是钱。
所以第一原则是:别让一段跟当前任务无关的历史,一直挂在你的对话里被反复重发。
一个任务一个对话
你在一个会话里先修了个 bug,又聊了下架构,又让它写了段文档,现在想问一个全新的问题——前面那三件事的完整来龙去脉,正挂在上下文里,跟着你这个新问题一起被重发、重算、重计费。
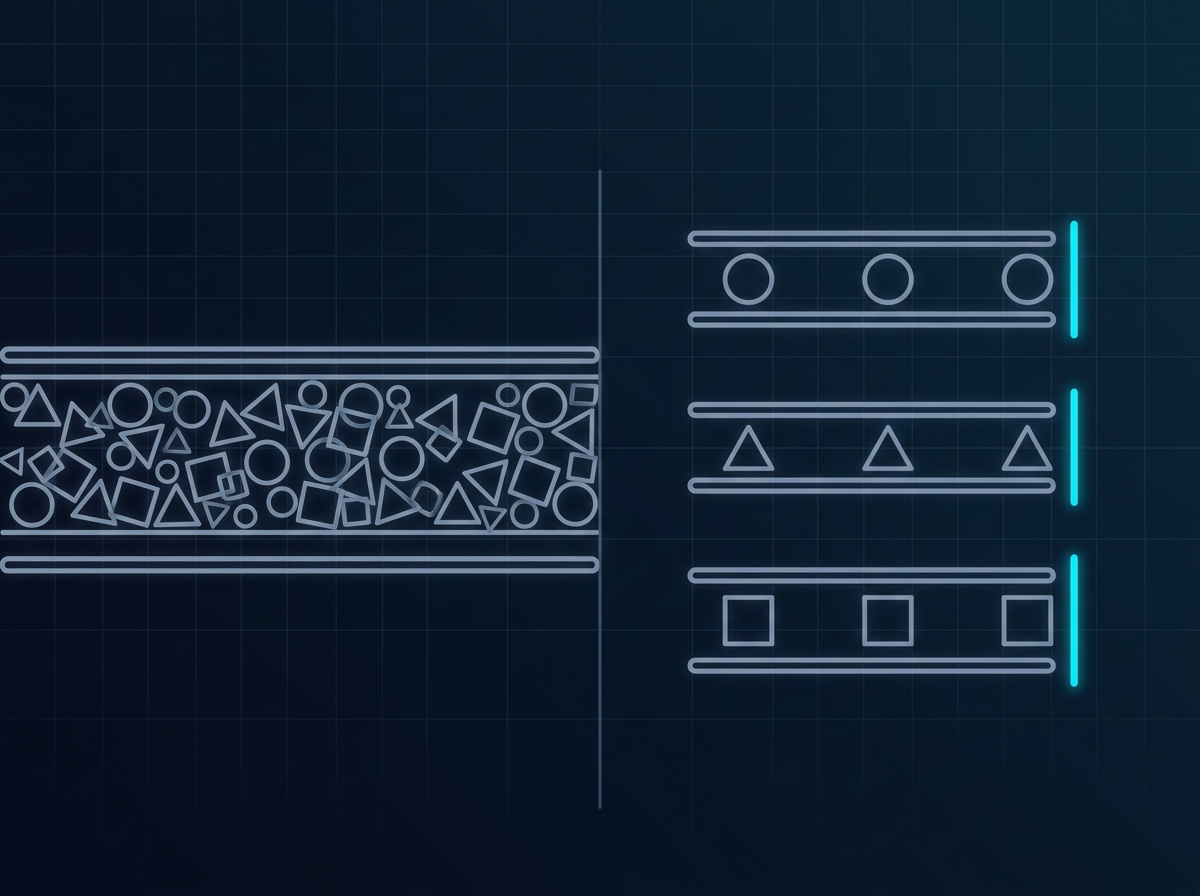
任务切换就开新对话。修完 bug 要写文档,/clear 一下再开始,别让 bug 的排查过程跟着文档任务跑一路。
别把一个会话晾在那儿几小时再回来接。要么连续干完,要么干完就清,中间停太久缓存过期,等于从头烧。
一个长任务中途实在不想丢线索,用 /compact,它会把前面压缩成摘要,比拖着原文便宜。但压缩这个动作本身也要花一次 token,而且会丢细节,别拿它当 /clear 用。
判据只有一句:这段历史,对我接下来要问的问题还有用吗?没用就 /clear。
别让它反复读文件
读文件是纯 input token,大文件一读就是几千上万。
- 让它精确读。别说"看一下这个文件",说"看
main.py的 40 到 90 行"。它读得越少,进上下文的越少。 - 改完不用再读一遍确认。Claude Code 自己会追踪文件状态,改动失败它当场就报错。你让它"改完再读一遍看看对不对",纯属白烧一遍那个文件。
- 警惕"读一下整个项目""建个全仓库索引"。这一句话下去,一堆文件全进上下文,之后每一轮都跟着重发。
给文件之前先想一下:删掉它,AI 还答得出这个问题吗?答得出就别给。
"读一大堆"的活儿,交给子 agent
翻遍整个仓库找某个东西、对比几种方案的差别——这类要读大量文件、但你只想要个结论的活儿,让它派一个子 agent 去干。
子 agent 在隔离的上下文里读那一堆文件,读完只把结论带回主对话。那些被翻过的文件原文,一个字都不进你的主窗口,之后每一轮也不会被重发。所以大范围搜索、跨文件调研、"看看有几处用到了 X",明确说一句"用子 agent 去查",别在主对话里一个个 cat。
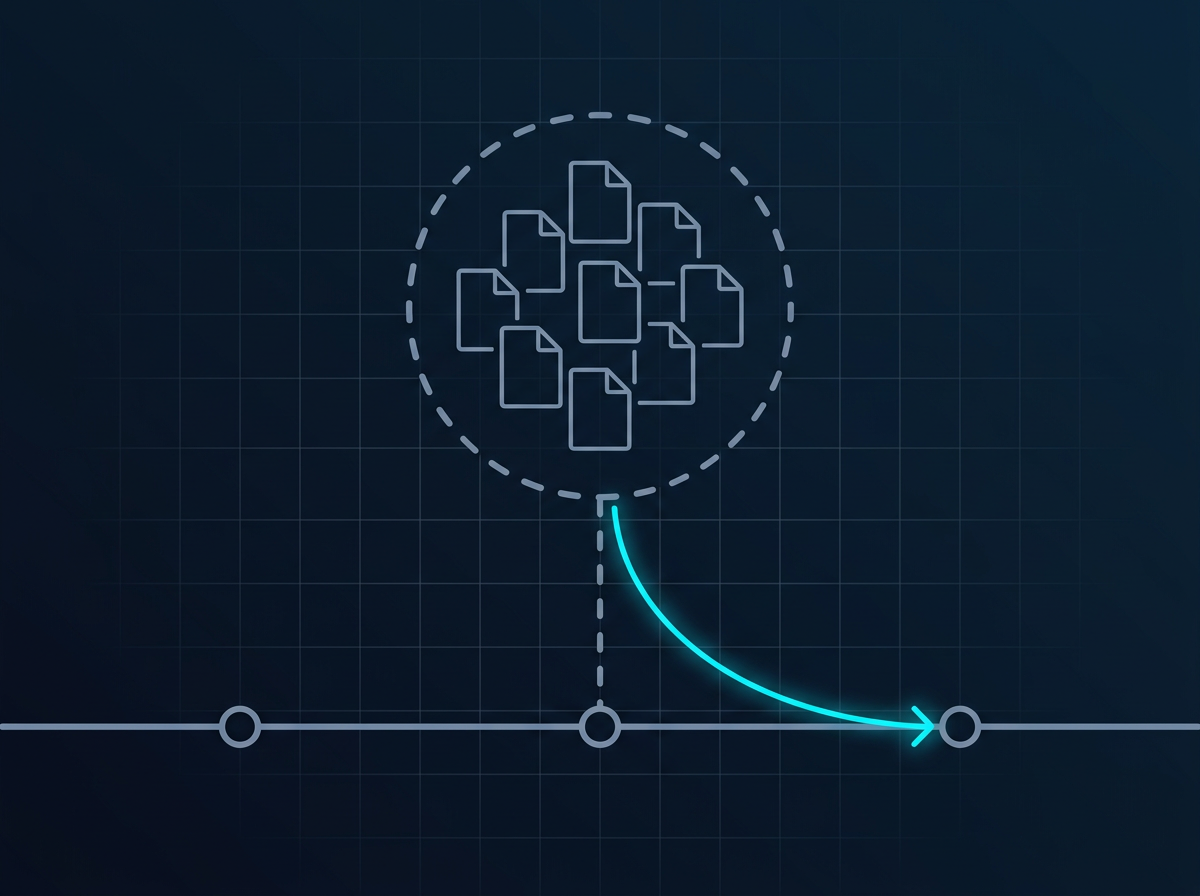
这一次读取省下的钱是小头。大头是这堆文件之后每一轮都不用再重发。
砍掉常驻上下文
你接的每一个 MCP server,它的工具定义都会常驻在上下文里,不管这次用不用得上,每一轮都跟着重发一遍。接了七八个 server、几十个工具,光这些定义就是一笔固定开销,还没开始干活就已经在付钱了。
先看一眼自己接了啥:
claude mcp list
只留当前项目真会用到的。那个你三个月前接、早忘了的 server,断掉。也别为了"以防万一"把每个可能用得上的工具都挂上,用得着的时候再加载。
给 CLAUDE.md 和 Skill 瘦身
CLAUDE.md 和被加载的 Skill,是每一轮都跟着重发的固定成本。你在里面画的那棵完整目录树、抄的那些 ls 一下就知道的信息,每问一句都在陪跑。
/doctor
它会给你的 CLAUDE.md 和 Skills 做一次瘦身体检,指出哪些是废话。删掉目录树,删掉"Claude 看一眼文件系统就知道"的东西,省下来的位置留给它真猜不到的坑。
简单活别用 Opus
模型差价不小(每百万 token,输入 / 输出):
| 模型 | 输入 | 输出 |
|---|---|---|
| Fable 5.1 | $10 | $50 |
| Opus | $5 | $25 |
| Sonnet | $2 | $10 |
| Haiku | $1 | $5 |
改个变量名、跑个格式化、写段模板代码、翻译一段,这些活儿用 Opus 是浪费。
/model
切到 Sonnet、Haiku,甚至本地部署的 LLM,同样的活儿花零头的价。需要深度推理的硬任务再切回 Opus / Fable。
同类的杠杆还有一个:简单任务把 effort 调低,它想得少、话也少,两头都省。
管住输出:让它别啰嗦
看那张表,输出 token 是输入的 5 倍价。让它少说,是性价比最高的一类节流。
- 别让它每次改完都把整个文件重新贴一遍给你看。要就要 diff。
- 别让它写长篇大论解释"我为什么这么改"。需要时再问。
- 结果对了,一句"好了"就够。
加在对话里很管用的一句话:"直接改,别解释,别复述文件。"
这些手段里最值钱的还是第一条,/clear 得勤一点。大多数人一个会话从早开到晚,把十件不相干的事堆在同一条时间线上,然后奇怪为什么越用越慢、越用越贵。