在 Mac 上部署 Strata + Qwen3.8-Flash-Next:新手教程
在 M4 Pro 64 GB 的 Mac 上用 Strata 跑 125B 的 Qwen3.8-Flash-Next:按内存选量化、一键安装、调到 64K 上下文、接入 Pi 做成后台服务,再让它无人值守写完一个俄罗斯方块 RPG 网页游戏,附实测速度和踩坑。
适用版本:Strata v0.1.44 / 0.1.44.1(截至 2026-10) 资料来源:Strata README、docs/MAC.md、v0.1.44 发布说明 实测环境:M4 Pro / 64 GB / macOS 26.5,下文的"实测"数据都来自这台机器。
这篇分三块:
- 把 Strata 和 Qwen3.8-Flash-Next 装到 Mac 上(第 1–7 节)
- 接入 Pi 编程智能体,改成后台服务(第 8–9 节)
- 实战:让 Pi + Strata 从零写一个"俄罗斯方块 + RPG"网页游戏(第 10 节)
这是什么?
- Qwen3.8-Flash-Next:一个约 125B 参数的 MoE 大模型。
- Strata:一个免费、MIT 协议的本地推理引擎,专门让这个大模型在普通电脑上跑起来。它把常用的"专家"放在 GPU 上,其余放在内存或 SSD 上,并用推测解码(MTP)提速。
- 跑起来之后你会得到:
- 浏览器聊天页面:
http://127.0.0.1:8080/ - OpenAI 兼容 API:
http://127.0.0.1:8080/v1 - Anthropic 兼容 API:
http://127.0.0.1:8080/v1/messages
- 浏览器聊天页面:
数据全在本机,不上传。
检查 Mac 配置
| 项目 | 要求 |
|---|---|
| 芯片 | Apple Silicon(M1 ~ M5)。Intel Mac 不能用 |
| 系统 | macOS 15 或更新 |
| 内存 | 最少 32 GB;64 GB 及以上体验好得多 |
| 硬盘 | 至少 80~120 GB 空闲,必须是内置 SSD |
| 工具 | Command Line Tools,不需要完整的 Xcode |
在"终端"(按 ⌘ + 空格,输入 Terminal)里运行下面的命令查看配置:
sysctl -n machdep.cpu.brand_string                          # 芯片
sysctl -n hw.memsize | awk '{print $1/1073741824 " GB"}'    # 内存
sw_vers -productVersion                                     # macOS 版本
df -h ~                                                     # 硬盘剩余空间
安装命令行工具(只需一次)
xcode-select --install
如果提示"已安装",或者你已经装了 Xcode,直接跳过这一步。
下载 Strata
mkdir -p ~/Dev/Qwen/FlashNext && cd ~/Dev/Qwen/FlashNext   # 放在哪里都可以
git clone https://github.com/Niko1221/Strata
cd Strata
发布页的 zip 里没有现成的 Mac 程序,Mac 版需要在本机编译,下一步的脚本会全自动完成。 v0.1.44 的问题已在 0.1.44.1 修复,直接 clone 主分支就是最新版。实测启动后显示
Strata 0.1.44.1-metal。
按内存选择模型大小
Metal 最多只让一个程序常驻约 3/4 的内存(64 GB 的 Mac 约 48 GB 可用)。
| 量化版本 | 实际约需内存 | 建议内存 |
|---|---|---|
| Q2_0 | 46 GB | 64 GB 起 |
| IQ3_XXS | 55 GB | 74 GB 起 |
| IQ3_S(官方推荐) | 63 GB | 96 GB 起 |
| UD-Q4_K_XL(Unsloth,质量更高) | 91 GB | 128 GB |
| UD-Q5_K_XL / UD-Q6_K_XL | 放不进内存,从 SSD 流式读取 | 128 GB |
怎么选:
- 32 至 48 GB:Q2_0 或 IQ3_XXS。引擎会自动改为从 SSD 读取专家,能用但慢(官方 M4 mini 32 GB 实测约 8~14 tok/s)。
- 64 GB:选 Q2_0。本教程用的就是它。
- 96 GB:选 IQ3_S。
- 128 GB 及以上:选 UD-Q4_K_XL。
⚠️ 如果你还在跑别的本地模型(例如 llama.cpp / LM Studio 里的 Qwen3.8 27B),它们会和 Strata 抢内存。64 GB 的机器上一次只开一个模型。
一键安装并启动
./setup.sh --check              # (可选)只检查 Mac 是否满足条件
./setup.sh --yes --model Q2_0   # 不提问,直接用 Q2_0 和其他推荐选项
想自己回答问题的话,就只运行 ./setup.sh,每个问题按回车用推荐值。
脚本会做的事,以及实测用时
| 步骤 | 做什么 | 实测(M4 Pro) |
|---|---|---|
| 准备 Python | macOS 自带 3.9 太旧,自动下载独立的 Python 3.12 到 .python(不需要 sudo 或 Homebrew) | 几秒 |
| 1. 检查 Mac | 芯片、内存、系统、工具、硬盘 | 秒级 |
| 2. 你的选择 | 模型大小、上下文长度(默认 32K) | — |
| 3. Python 依赖 | 安装到 .venv | 约 1 分钟 |
| 4. 编译 Metal 引擎 | 生成 build-metal/strata | 约 5 分钟 |
| 5. 下载模型 | 两个文件:主模型 37.6 GB + n-gram 表 28.8 GB | 约 2 小时(网速 6~10 MB/s) |
| 6. 准备模型 | 生成模型包和 MTP 草稿层 | 几分钟 |
| 7. 生成配置 | 写出 strata-q2_0.json 和 run-q2_0.sh,然后启动 | 约 1 分钟 |
下载断了就重新跑
./setup.sh,会续传。 下载要两个小时左右,可以把输出写进日志,放在后台跑:./setup.sh --yes --model Q2_0 > ~/strata-setup.log 2>&1 & tail -f ~/strata-setup.log # 随时查看进度,按 Ctrl+C 退出查看(不影响安装)
第一次启动
看到下面这行,就说明启动成功了:
ready: http://127.0.0.1:8080/v1 (OpenAI: /v1/chat/completions, Anthropic: /v1/messages, context 32768 tokens)
- 启动时 1~3 分钟内电脑可能会卡,它在读几十 GB 的模型,等它读完就好。
- 浏览器会自动打开聊天页面。
- 用命令行测一下:
curl http://127.0.0.1:8080/v1/chat/completions \
  -H "Content-Type: application/json" \
  -d '{"model":"any","messages":[{"role":"user","content":"用三句话介绍一下你自己。"}]}'
实测速度(M4 Pro 64 GB,Q2_0)
| 指标 | 实测 |
|---|---|
| 生成速度 | 约 29~37 tok/s(中位数 34) |
| prefill | 约 170~300 tok/s |
| 重复的前缀 | 直接复用缓存,几乎不花时间 |
作为对比,官方 M5 Max 128 GB 的生成速度约 110~120 tok/s。M4 Pro 的内存带宽不到它的一半,慢这么多说得通。
日常命令
都在 Strata 文件夹里运行:
| 想做什么 | 命令 |
|---|---|
| 再次启动(不会重新下载) | ./setup.sh 或 ./run-q2_0.sh |
| 换模型或改设置 | ./setup.sh --setup |
| 只更新,不启动 | ./update.sh |
| 测速 | ./bench.sh |
| 重新编译引擎 | ./setup.sh --build |
| 停止 | 在运行它的终端里按 Ctrl + C |
配置文件是 Strata/strata-q2_0.json,改完要重启才生效。常改的几项:
"--max-context":上下文长度"--spec":推测解码窗口(Mac 默认 2)- 在 JSON 顶层加
"reasoning_effort": "medium":没有指定思考档位的请求,就默认用这一档
接入 Pi 编程智能体
Pi(https://github.com/badlogic/pi-mono) 是一个终端里的编程智能体,可以读写文件、运行命令,和 Claude Code 类似。Strata 的接口支持 Pi 需要的全部功能:工具调用(包括多个并行调用)、reasoning_content 思考输出,以及 reasoning_effort 的 minimal~xhigh 全部档位。
把上下文调到 64K
Pi 很吃上下文。实战中一次开发会话的上下文最高到了约 55K(见第 10 节),默认的 32K 不够用。
编辑 Strata/strata-q2_0.json,先备份:
cd ~/Dev/Qwen/FlashNext/Strata
cp strata-q2_0.json strata-q2_0.json.bak-32k
sed -i '' 's/"32768"/"65536"/' strata-q2_0.json
grep -A1 max-context strata-q2_0.json     # 应显示 65536
⚠️ 官方在 Mac 上只测到 32K。64K 在本机实测可用,但如果长对话出现异常,恢复
.bak-32k就行。 Pi 的~/.pi/agent/settings.json里如果有compaction.reserveTokens(比如 45056),它必须明显小于上下文长度,否则 Pi 每一轮都会触发压缩。这也是本教程选 64K 的原因之一。
在 Pi 里添加 Strata
编辑 ~/.pi/agent/models.json,在 providers 里加一个 strata。如果原来已有别的 provider,就和它并列:
{
  "providers": {
    "strata": {
      "baseUrl": "http://127.0.0.1:8080/v1",
      "api": "openai-completions",
      "apiKey": "local",
      "compat": {
        "supportsDeveloperRole": false,
        "supportsReasoningEffort": true
      },
      "models": [
        {
          "id": "qwen3.8-flash-next-q2_0",
          "name": "Qwen3.8 Flash Next Q2_0 (Strata)",
          "reasoning": true,
          "input": ["text"],
          "contextWindow": 65536,
          "maxTokens": 16384
        }
      ]
    }
  }
}
| 字段 | 说明 |
|---|---|
id | 必须和 curl http://127.0.0.1:8080/v1/models 返回的 id 一致 |
supportsReasoningEffort: true | 让 Pi 的思考档位直接传给 Strata |
input: ["text"] | Mac 版暂不支持图片输入 |
maxTokens | 单次回复的上限。写大文件时会碰到它,见第 10 节的经验 |
在 Pi 里输入 /model,选 Qwen3.8 Flash Next Q2_0 (Strata)。也可以直接用命令行测试:
mkdir -p /tmp/pi-test && cd /tmp/pi-test && echo "hello strata" > note.txt
pi --provider strata --model qwen3.8-flash-next-q2_0 -p "读取 note.txt,用一句话告诉我里面写了什么"
实测:Pi 会先调用 read 工具读取文件,再正确回答。第一轮约 1 分钟,主要花在读 Pi 约 8.9K tokens 的系统提示上;之后几轮复用缓存,1~2 秒就开始回答。
做成后台服务
./run-q2_0.sh 需要一直开着一个终端窗口,而且每次都会打开浏览器。给 Pi 用的话,更方便的做法是做成后台服务。
启动脚本 ~/.local/bin/strata-serve
#!/bin/zsh
# Strata (Qwen3.8-Flash-Next Q2_0) —— 后台启动,:8080,给 pi 用
STRATA="$HOME/Dev/Qwen/FlashNext/Strata"
LOG_DIR="$HOME/Library/Logs/strata"
mkdir -p "$LOG_DIR"

if curl -s -m 2 http://127.0.0.1:8080/v1/models >/dev/null 2>&1; then
  echo "Strata 已在运行: http://127.0.0.1:8080/v1"
  exit 0
fi

# 64 GB 放不下两个模型:先卸载 llama.cpp router 里的 27B(没有就跳过这段)
curl -s -m 5 -X POST http://127.0.0.1:8081/models/unload \
  -H "Content-Type: application/json" \
  -d '{"model":"Qwen3.8-27B-Q4_K_M"}' >/dev/null 2>&1 && echo "已卸载 27B(:8081)"

cd "$STRATA" || exit 1
nohup "$STRATA/.venv/bin/python" "$STRATA/serve/server.py" \
  --engine strata --config "$STRATA/strata-q2_0.json" \
  --host 127.0.0.1 --port 8080 \
  > "$LOG_DIR/server.log" 2>&1 &
echo "Strata 启动中(约 1 分钟),日志: $LOG_DIR/server.log"
停止脚本 ~/.local/bin/strata-stop
#!/bin/zsh
if pkill -f "serve/server.py --engine strata"; then
  echo "已停止 Strata"
else
  echo "Strata 没有在运行"
fi
设置权限和别名
chmod +x ~/.local/bin/strata-serve ~/.local/bin/strata-stop
在 ~/.zshrc 里加上下面两行,然后运行 source ~/.zshrc:
alias strata-serve="$HOME/.local/bin/strata-serve"
alias strata-stop="$HOME/.local/bin/strata-stop"
日常用法
strata-serve     # 启动(会自动卸载 27B),约 1 分钟后就绪
pi               # /model 选 Strata
strata-stop      # 用完停掉,释放约 46 GB 内存
在 27B 和 Strata 之间切换:先
strata-stop,再在 Pi 里选回 27B。如果 llama.cpp router 设置了--no-models-autoload,就要先手动加载一次 27B。 ⚠️ 在 Pi 里,模型和服务要对应。如果 Pi 当前选的是 27B,但它已经被strata-serve卸载了,就会报400: model is not loaded。用/model切到 Strata 即可。实战中第一条消息就遇到了这个问题。
实战:用 Pi + Strata 开发一个网页小游戏
需求(只发了一句话)
开发一个有rpg玩法元素的俄罗斯方块游戏,html格式输出,丰富的动效,游戏可正常运行
结果
tetris-rpg.html:单文件,1077 行,47.7 KB,没有任何依赖,双击就能玩。
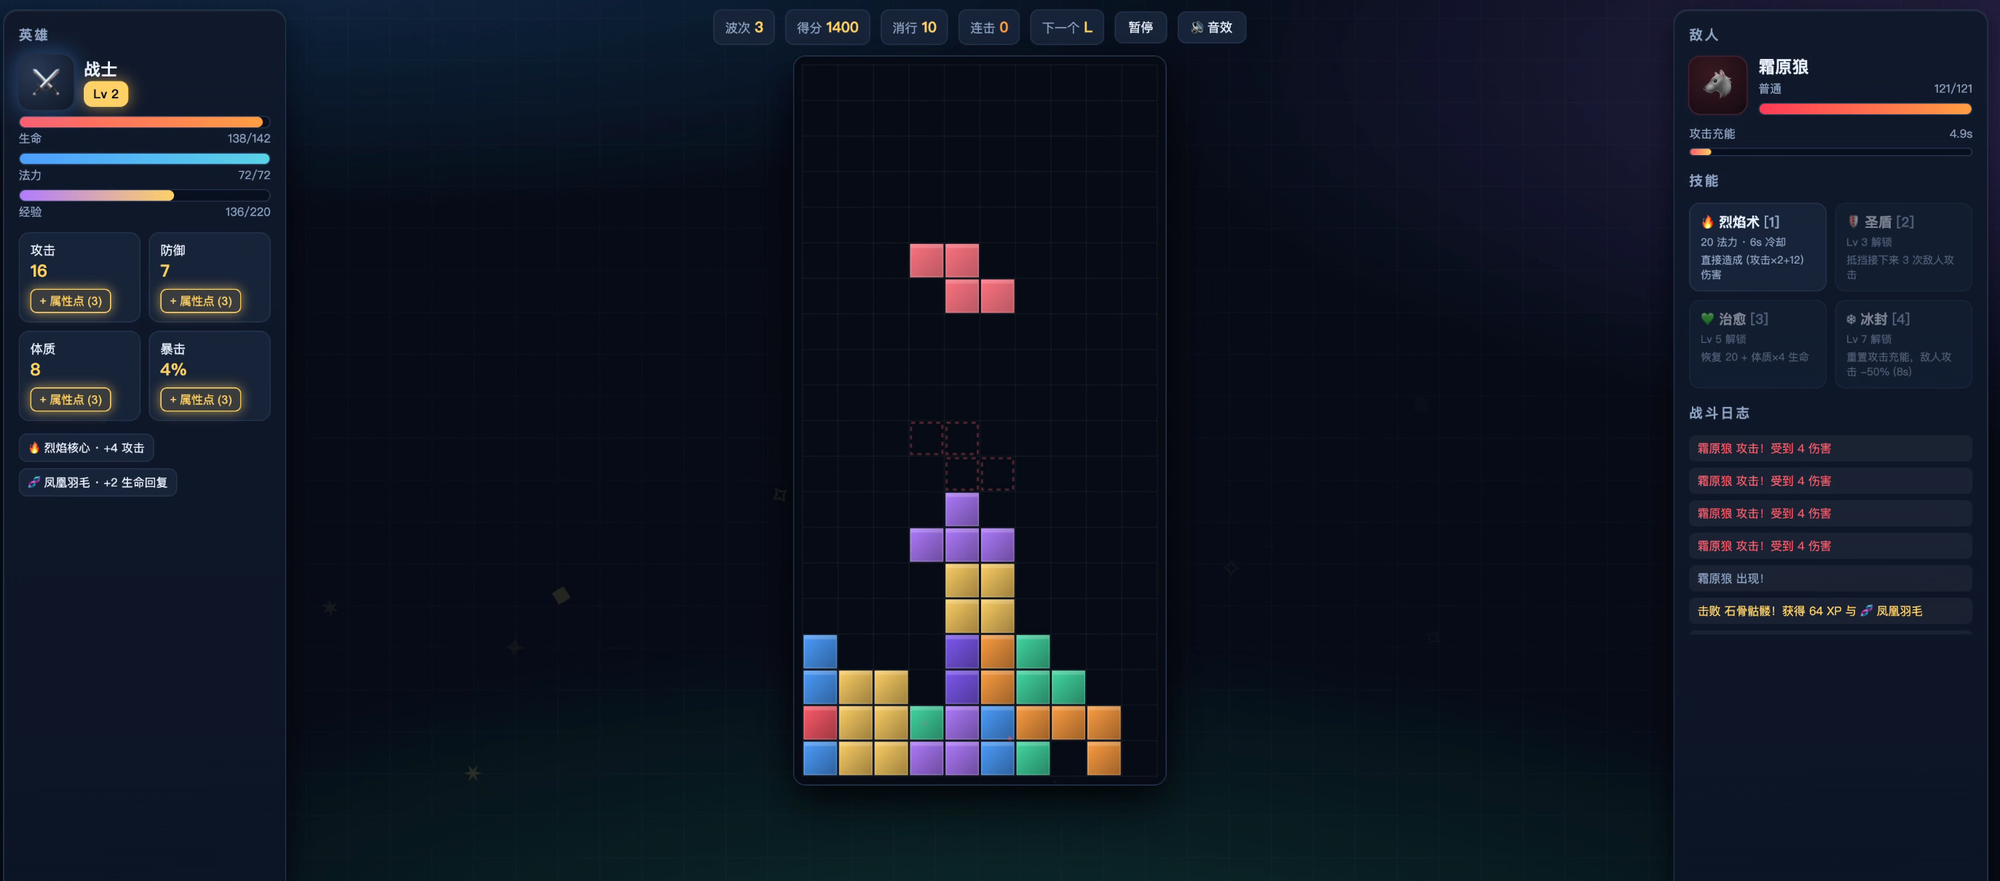
- 玩法:3 个职业(战士、法师、刺客);消行会对敌人造成伤害;有经验值、升级和属性点;每 5 波一个 BOSS;4 个技能(烈焰、圣盾、治愈、冰封),带冷却和法力消耗;6 种遗物;支持 T-Spin、连击和暴击。
- 动效:极光背景、消行闪光和粒子、伤害数字、攻击光束、屏幕震动、升级爆发、低血量警告、落点预览、WebAudio 音效,还有适配手机的触控按钮。
- 测试:模型自己写了两套无头测试,在 Node 里模拟 DOM 和 canvas:
rpg_test.js:34 项断言,覆盖职业、技能、护盾、冰冻、遗物、死亡、棋盘溢出、T-Spin 等long_test.js:连续玩 20 波不出运行时错误,粒子数量有上限,网格始终是 20×10
会话数据
| 指标 | 数值 |
|---|---|
| 总用时 | 约 1 小时 50 分钟,全程无人干预 |
| 模型回复轮数 | 135 轮,其中 131 轮是工具调用 |
| 工具调用 | bash 73 次、read 18 次、edit 18 次、write 12 次 |
| 上下文最高 | 约 55K tokens(说明 32K 不够用) |
| Token 用量 | 输入约 46 万(其中 87% 命中缓存),输出约 13 万 |
| 时间去向 | 生成约 68 分钟,读提示约 37 分钟 |
| 生成速度 | 中位数 34 tok/s |
写需求的小模板
开发一个 <什么东西>,<输出格式>,要求 <关键功能>。
- 文件较大时请分段写入再合并
- 写无头测试(Node)验证核心逻辑,确保全部通过后再结束
- 最后总结功能和测试结果
当前限制(Mac 版)
- 一次只处理一个请求,多个客户端会排队。这会影响 Pi 的子智能体。
- 上下文官方只测到 32K;64K 在本机实测可用。
- 只支持文字,Mac 版没有图片输入(安装时用
--vision yes可以开启,但测试很少)。 - Swift、Coder 版本暂时不能在 Mac 上安装;Qwen3.6 不能在 Mac 引擎上运行。
- 模型文件必须放在内置 SSD 上。