Claude 写计划,本地部署 Qwen 执行,能不能更省钱?
同一段 15 秒 Spine 猫扑鱼动画,一组让 Claude 全做,一组让 Claude 写方案、本地 Qwen 写代码渲染。Claude token 少了 70%,费用只少 28%,耗时却是 3.6 倍,画面也更差。附完整 token 账单和原因分析。
实验记录 · 2026-11-05 · 1280×720 · 30 fps · 450 帧
一组让 Claude 从头做到尾;另一组让 Claude 只写方案,交给本地部署的 Qwen 去写代码、渲染、合成。两组都交出了完整的视频。省下的钱比省下的 token 少得多,花掉的时间却多出好几倍。
想回答的问题
本地模型不要钱,就是能力差一截,Claude 则按 token 收费。于是有个很常见的设想:让贵的模型只做“动脑子”的部分(规划、写说明),让便宜的模型做“动手”的部分(写代码、跑命令、排错)。这样到底能省多少?
为了让对比有意义,我选了一个需要真实动手的任务:用一批现成的 Spine 骨骼动画素材,做一段 15 秒的小动画。故事很简单:一只猫走进画面,发现一条小丑鱼,盯住、蓄力、扑上去,抓到后吃掉,最后心满意足。
素材和准备工作
素材目录里有 119 套 Spine 资源,全部是 4.0.64 版本的二进制格式(.skel.bytes + .atlas.txt + .png)。猫有 30 个动作(walk、focus、jump、eat2、happy2、sit……),鱼只有 swim 和 fight。两组都固定使用猫 Cat_01 和小丑鱼 Fish_dqxq_01。
开工前我先做了一轮两组共用的准备,避免任何一组在环境问题上白白烧 token:
- 装好
spine-webgl 4.0.31(必须是 4.0.x,4.1 读不了 4.0 的二进制)和puppeteer-core。 - 用真实运行时把每个骨骼加载一遍,生成
manifest.json:动作名、时长、包围盒。模型只能从这份清单里选动作名,不能猜。 - 写了一份统一的需求文档和一个验收脚本
verify.sh:检查 1280×720、30 fps、正好 450 帧、H.264、无黑帧,并输出每秒一帧的缩略图。 - 写了 token 统计脚本,分别读取 Claude Code 和 pi 的会话日志。
这部分准备工作本身也花了 Claude 的 token(约 $1.3),但两组都受益,所以不计入任何一组。
两组怎么分工
A 组:Claude 全做
- 新开一个 Claude Code 会话(Claude Opus 5.5),只给需求文档和素材清单。
- 它自己写分镜、写代码、渲染、看缩略图、改问题,直到验收通过。
B 组:Claude 规划 + Qwen 执行
- 新开一个 Claude Code 会话,同样的输入。只允许产出两份文档:
storyboard.md(分镜)和TASK_FOR_QWEN.md(任务说明),禁止写任何代码。 - 本地 Qwen3.8 Flash Next(Q2 量化,64K 上下文,无图片输入)在 pi 编码代理里读这两份文档,写代码、渲染、合成。
- 预留了最多 3 次“继续”催促和 Claude 救援轮,失败时修订文档,费用单独记账。
结果
两组都一次通过验收。Qwen 没有被催促过,也没有用到救援轮。
| 环节 | 请求数 | input | output | cache 写 | cache 读 | 合计 tokens | 费用 | 耗时 |
|---|---|---|---|---|---|---|---|---|
| A · Claude 全流程 | 30 | 60 | 32,701 | 103,362 | 1,322,644 | 1,458,767 | $1.44 | 424 s |
| B · Claude 规划 | 12 | 24 | 27,260 | 83,742 | 329,590 | 440,616 | $1.03 | 283 s |
| B · Qwen 执行(本地) | 44 | 92,331 | 28,489 | 0 | 1,169,958 | 1,290,778 | $0 | 1,254 s |
| B 组合计 | 56 | 1,731,394 | $1.03 | 1,537 s |
| 指标 | A 组 | B 组 | B / A |
|---|---|---|---|
| Claude tokens | 1.46M | 0.44M | 30% |
| Claude 费用 | $1.44 | $1.03 | 72% |
| 总耗时 | 424 s | 1,537 s | 363% |
Claude 的 token 少了 70%,费用只少了 28%;总耗时却变成了原来的 3.6 倍。
为什么 token 和钱对不上
原因在计费结构。Claude Opus 5.5 的输出是每百万 $20,缓存读取只要每百万 $0.20,相差 100 倍。
写一份让弱模型也能照做的任务说明,本身就要输出大量文字。B 组规划阶段输出了 2.7 万 tokens,和 A 组全程的 3.3 万相差不大。A 组多出来的一百多万 token,绝大部分是每一轮对话重复读取的缓存上下文,单价很低。所以只看 token 总数,会严重高估“交给本地模型”省下的钱。
反过来,Qwen 的 129 万 tokens 不花钱,但花时间:在本机跑了约 21 分钟,是 A 组全程的 3 倍。
画面对比
下面是两段视频每秒一帧的缩略图,从左到右、从上到下是第 0 到第 14 秒。
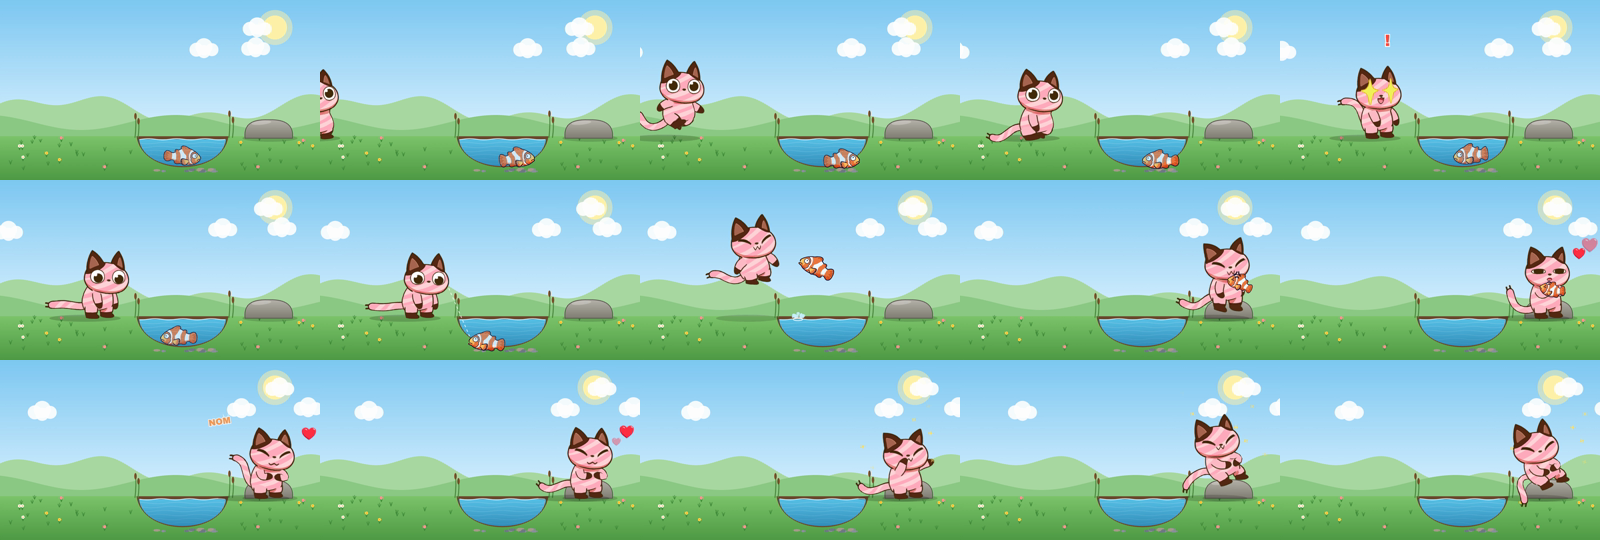
A 组:池塘、山坡、石头和水花都是代码画的。鱼从水里跃起,猫在空中扑住,再捧着鱼吃,最后坐到石头上眯眼。
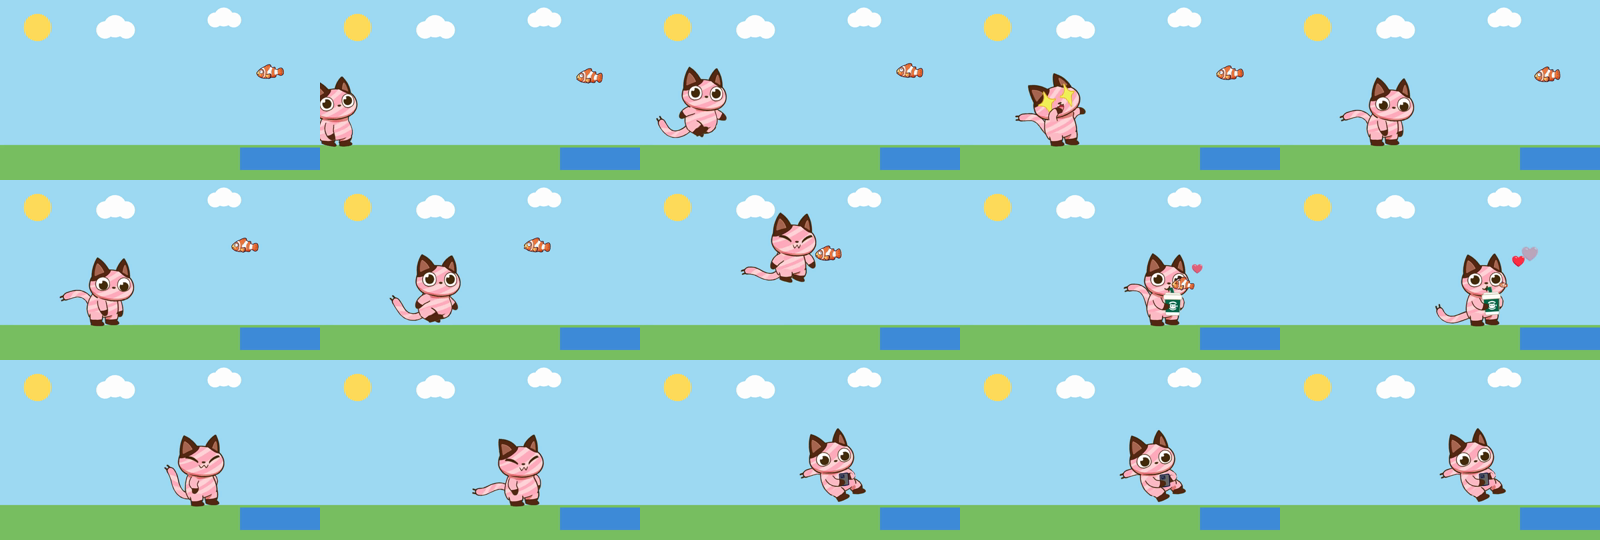
B 组:背景是纯色块,鱼飘在天上。猫扑鱼的过程是对的,但吃鱼和坐下时,动作自带的鱼形零食和手机没有隐藏。
两组的验收脚本都输出了 PASS,因为它只检查尺寸、帧数、编码和黑帧这些技术指标。但画面质量的差异特别大,QWen做出来的画面质量效果差很多。
eat2 和 sit 两个动作在骨骼里自带道具(一个鱼形零食、一部手机)。A 组的 Claude 渲染后看了缩略图,发现了道具,把它们隐藏掉,改成在猫爪里画那条真鱼,并随着啃食逐渐缩小。B 组的分镜里没有预见到这一点,而 Qwen 没有图片输入,无法自己发现。
Qwen 的表现
单论执行,Qwen 做得比预期好:
- 严格按文档的 5 个步骤推进,每一步都跑了文档里写的自检命令。
- 自己发现并修复了一个文档没提到的问题:页面缺少
<meta charset="utf-8">,Chrome 把脚本里的中文路径解码成乱码,素材全部 404。 - 看不了图,就用 ffmpeg 导出原始像素,按颜色找猫和鱼的位置,核对是否和分镜的坐标一致。
它能做好,很大程度上是因为 Claude 的任务说明写得很细:文件结构、函数接口、API 片段、每一步的预期输出都给了。这正是 B 组规划阶段输出那么多 token 的原因。说明写得粗一点,Claude 会便宜一些,但 Qwen 失败、需要救援的概率会上升,救援轮的费用又会加回来。
结论
钱省了 28%,也就是 $0.41。规划文档如果能复用到一批同类任务上,摊薄后会更划算。
速度和质量都是 A 组赢,7 分钟对 26 分钟,画面也完整得多。关键在能看图:渲染完自己看缩略图、自己改,动画这类任务很吃这一点。
Qwen 是这次最意外的部分。Qwen3.8 Flash Next 量化到 Q2,只要说明写得够精确,也能独立做完一个多文件、带浏览器渲染和视频合成的任务,中途还能自己排错。
局限
每组只跑了一次。模型本身的随机性就可能让数字差几十个百分点,这次结果只是一个数据点。准备工作(约 $1.3)不计入任何一组;没有现成的素材清单和渲染验证,两组、尤其是 Qwen,大概率需要更多轮次。费用按 Anthropic 官方标价计算(输入 $4、输出 $20、缓存写 $5、缓存读 $0.20,每百万 tokens),和 Claude Code 自身报告的金额一致。