本地部署 Qwen-Image-2.1:踩坑记录
在 24GB 显存上部署 33GB 的 Qwen-Image-2.1:Python 与 CUDA 版本、CPU offload、VAE 解码 OOM、常驻 HTTP 服务,以及漫画生成实测效果。
Qwen-Image-2.1 是通义千问团队 2026 年 9 月开源的图像生成模型,文生图、图像编辑、透明图生成都用同一个模型。今天在一台新设备上把它部署了一遍,坑不少,记一下。
Python 版本太旧
官方要求 transformers>=5.17,它已经不支持 Python 3.9。系统 Python 我没动,用 uv 新建了一个 3.11 的虚拟环境,几秒钟的事。
驱动只到 CUDA 12.2
新版 PyTorch 已经不提供 cu121 的包了。好在 CUDA 有小版本兼容,cu126 的包能跑在 12.2 驱动上。装完我先跑了一次 bf16 矩阵乘法,确认 GPU 真的能算,才接着往下装依赖。
33GB 的模型,24GB 的显存
放不下,只能开 enable_model_cpu_offload():模块轮流搬进显存,文本编码器算完挪回内存,再换 DiT 上来。实测显存峰值 17.6GB。
代价是整个模型要常驻内存。free 显示可用只有 37GB,我一度以为不够。查了 cgroup 才发现,大部分"已用"是下载模型时留下的页缓存,可以回收。所以现在判断内存够不够,我直接看 cgroup,free 的数字只当参考。
跑了 5 分半,死在最后一步
用官方推荐的 2048×2048 跑完 40 步去噪,花了 5 分半钟,然后在 VAE 解码阶段 OOM,前面全白跑。
问题出在我脚本里写的 if hasattr(pipe, "enable_vae_tiling")。这个 pipeline 根本没有这个方法,分块解码就这么被悄悄跳过了,一点提示都没有。改成直接在 VAE 上调 pipe.vae.enable_tiling(),再加上 PYTORCH_CUDA_ALLOC_CONF=expandable_segments:True,才跑通。
这种"防御式"的 hasattr 判断会把配置错误藏起来。以后宁可让它直接报错。
每次都要重新加载模型
脚本出图,第一步就得等 97 秒,大头是加载 33GB 权重。于是我把模型包成了常驻的 HTTP 服务:
- 一张 2048 的图要 4~7 分钟,同步请求很容易超时,所以做成异步:提交任务、查进度、下载结果。
- 只有一张卡,任务进单线程队列,一个一个跑。
模型常驻以后,同样一个 1024px 的编辑任务从 4 分钟降到 47 秒。
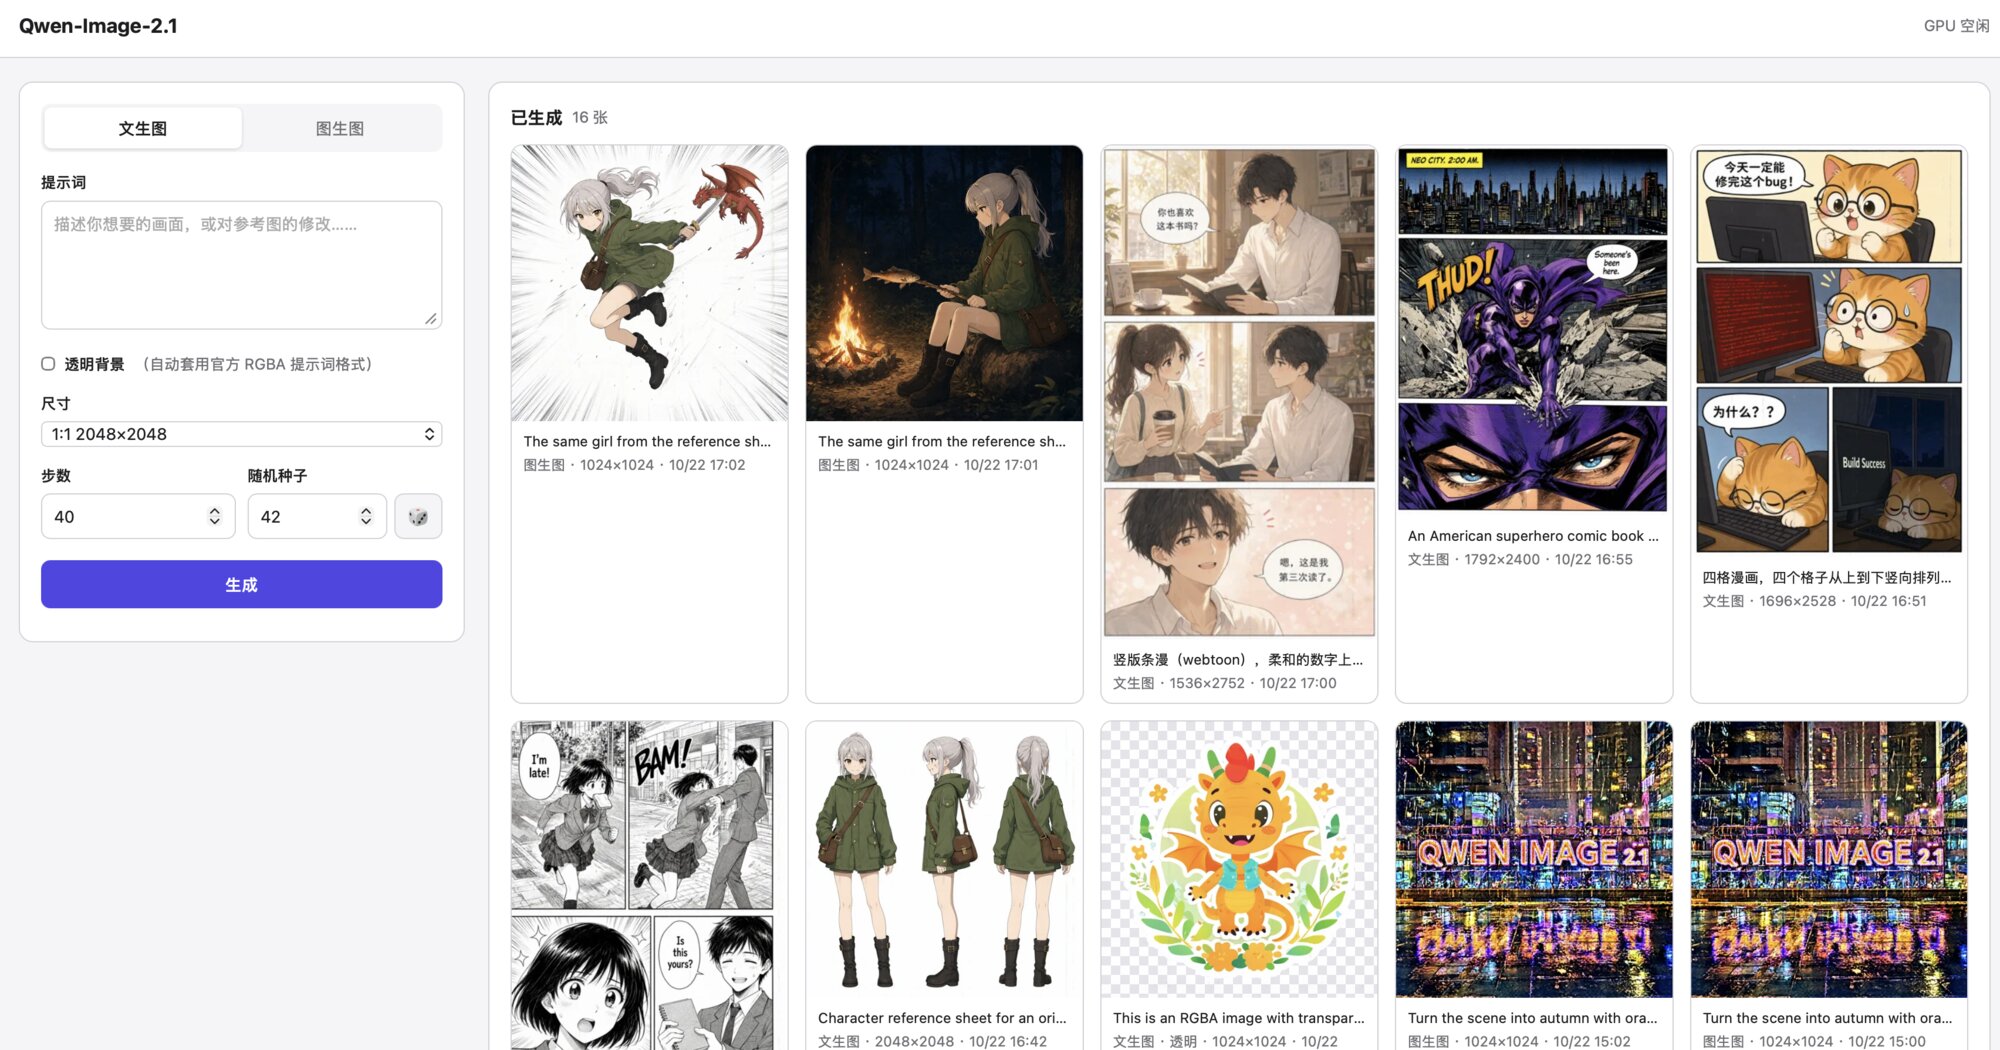
后来又加了个 Web 页面,顺手踩了两个前端小坑。一个是 <img> 标签带不了 Authorization 请求头,图片只能先 fetch 成 blob,再生成链接显示;另一个是 CSS 里写了 display:flex 的元素,HTML 的 hidden 属性会失效。这两个都是在服务器上用无头 Chromium 跑完整流程、翻截图时才发现的,页面能打开的时候我完全没意识到有问题。
漫画比我预期的好
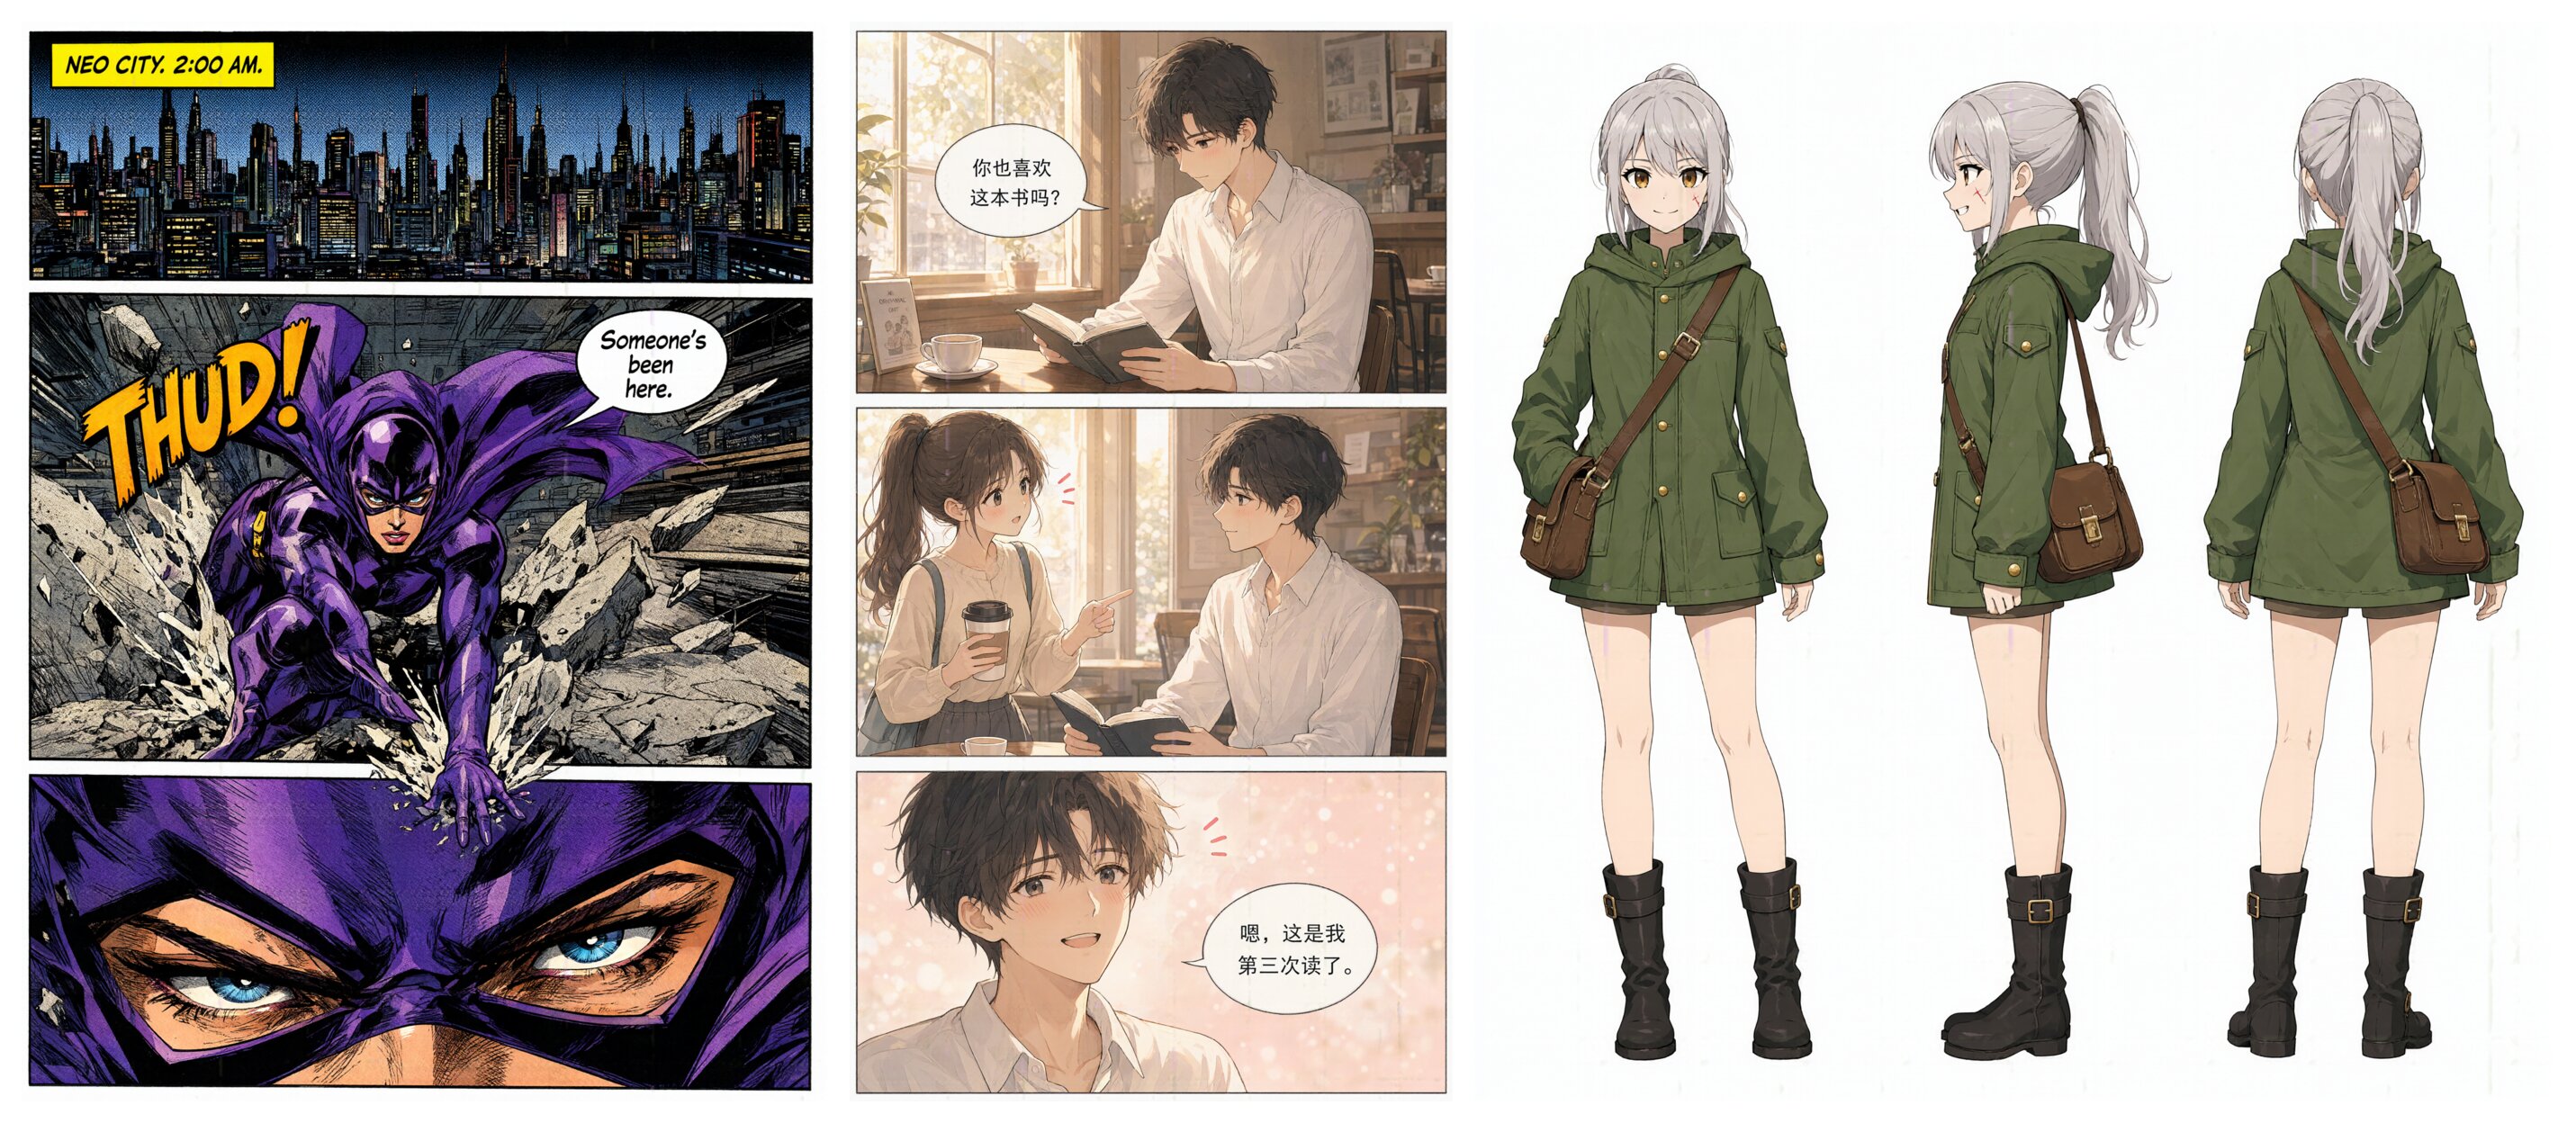
我设计了 7 个漫画测试:日漫、中文四格、美漫、条漫,再加角色一致性。分格排版、网点、画风都很到位,中英文对白几乎一字不差。角色一致性也过关,给一张设定图做参考,同一个角色能放进不同场景里。
问题也有。对白偶尔放错格,复杂动作画不准。
回头看
动手前先把驱动、Python、显存、cgroup 内存这几样摸清楚,方案基本就定了。
offload 加分块解码是小显存跑大模型的常规组合,但每一项都得实际确认生效。VAE 那次 OOM,代码里明明"写了",实际根本没跑。出图也一样,出了图要一张张看,效果不对就做对照实验找原因。
速度上,24GB 显存跑 2048 分辨率单图约 4.5 分钟,1024 约 1 分钟。个人创作或者小团队内部用,够了。