Claude 模型详解:如何为你的用例选择最佳模型
如何为你的工作负载选择合适的 Claude 模型:比较各模型类别,权衡每任务成本与每 token 成本,并构建评估来做出最终决策。
原文:Anthropic
我们的建议:从最强模型开始
我们最常被问到的问题之一是"这个工作负载该选哪个模型?"随着我们发布了更多模型类别和版本,答案变得更加细致。
本文涵盖了这些细节,包括每个模型类别的描述、选择模型时应考虑的核心问题,以及其他最佳实践。
先抛开细微差别,我们的默认建议是:从最智能的通用模型开始,然后使用 effort level(努力等级)来调节性能和成本的平衡。
更智能的模型通常每任务成本更低,尤其是在较低 effort level 下,即使每 token 价格更高也是如此。这是因为更强的模型往往需要更少的轮次和更少的思考时间就能正确完成大多数任务。从较小的模型开始还会让你更难区分"模型能力不够"和"配置有问题"。
当然,当用例对延迟或成本更敏感时,你可以测试更低级别的模型,直到找到理想方案。
一些组织也可能选择从最经济的模型开始,逐步升级直到满足质量标准。我们在模型选择文档中包含了这两种方向性方法。
Claude 模型家族
Mythos / Fable
Mythos 是 Anthropic 最强大的模型类别,在各领域都具有前沿能力。该类别在编程、长时间运行的 Agent 任务,以及解决 AI 此前无法可靠处理的问题方面尤为出色。
Mythos 类别以同一底层模型的两个封装形式发布。Claude Mythos 面向处理双用途网络安全和生物学工作的受信任组织,而 Claude Fable 则附带额外安全措施,使模型可安全供公众使用。两者都要求有限数据保留以确保安全使用。
Opus
Opus 是我们面向推理密集型企业任务的强大模型类别。Opus 模型在 GDPval-AA(知识工作)和 Terminal-Bench 2.1(Agent 编程)等关键行业基准测试中持续名列前茅。
Opus 与 Fable 之间的选择表面上可能不太明显,因为两者都擅长编程、长时间运行的 Agent 和知识工作。在实际场景中,更大的模型如 Fable 虽然基准分数与 Opus 相似,但往往具有更多智慧、创造力和写作能力。
一般经验法则是:如果你的评估或内部测试显示 Opus 在某些任务上表现吃力,那就用 Fable。如果 Opus 已经达到了质量标准,那么它的速度和价格可能使其成为更好的选择。
Sonnet
Sonnet 是我们面向日常任务的通用模型类别。Sonnet 在性能、成本和速度之间提供平衡,适用于最广泛的通用场景,包括多 Agent 编排中的高频子 Agent。
Haiku
Haiku 是我们成本最低、速度最快的模型类别。Haiku 模型专为延迟和成本敏感的高频工作负载设计。
如何为你的工作负载选择最佳 Claude 模型
我们的模型类别并不专精于某一类工作。我们不会推荐某个模型用于金融而另一个用于科学。每个 Claude 模型都在编程、Agent 任务和知识工作等领域经过训练以达到卓越表现。
各模型类别的主要区别在于它们能可靠承担多难的问题,以及该能力在价格和速度上的代价。选择模型时,请考虑:
这个任务有多难? 如果通常需要大量时间、涉及多个步骤,或是此前未解决的问题,那么更强的模型类别更合适。
延迟需求是什么? 如果模型参与高频面向客户的工作负载,Sonnet 通常是最佳选择。
访问限制是什么? Mythos 仅对 Project Glasswing 下的组织开放。并非所有组织对所有角色都开放所有模型类别。
单位经济如何? 更高的生产量可能更适合较低级别的模型,特别是当评估显示这些任务能令人满意地完成时。不同模型的每 token 定价不同,基于其能力和 effort level 将有不同的每任务成本。
Effort level 也会影响质量、速度和成本的平衡。更高类别的模型在更高 effort 下提供最佳性能,而更高类别的模型在较低 effort 下有时比较小的模型更高效。
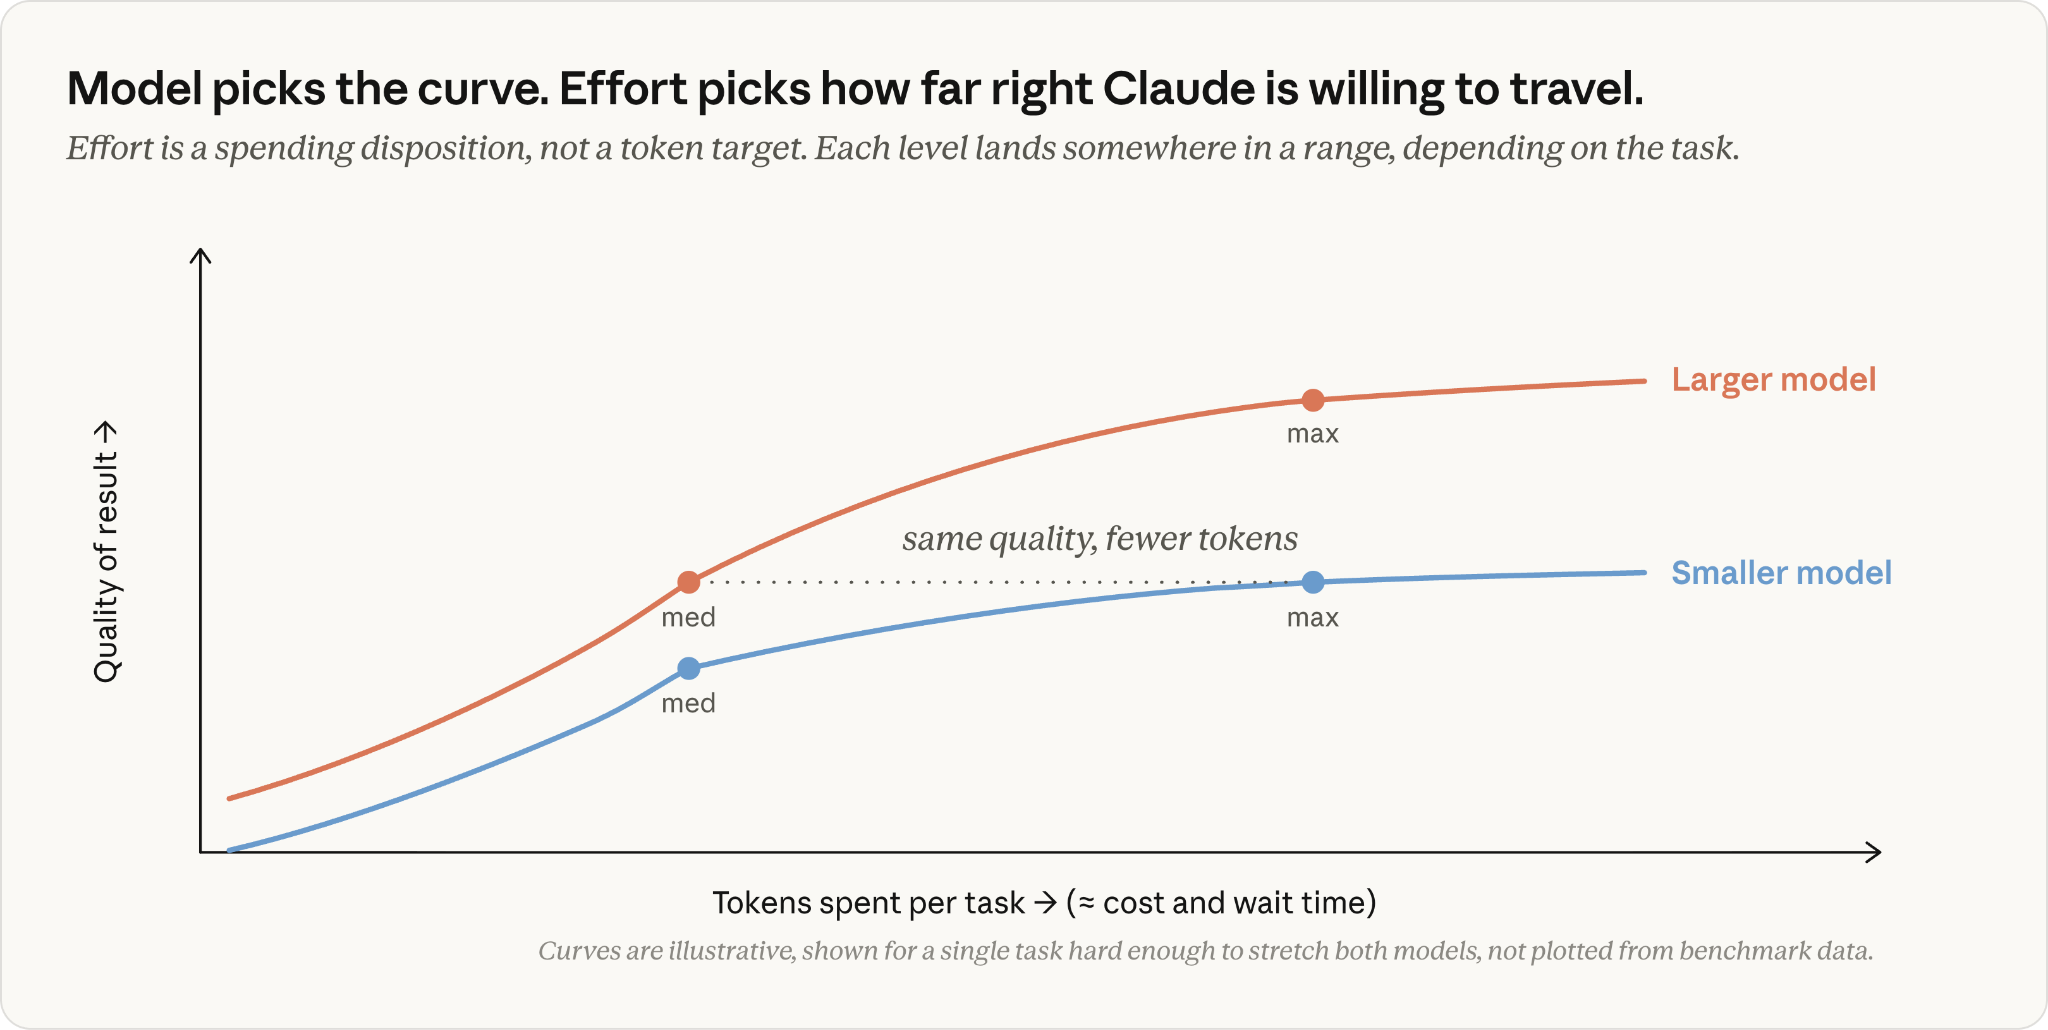
曲线为示意图,未基于基准测试数据绘制。
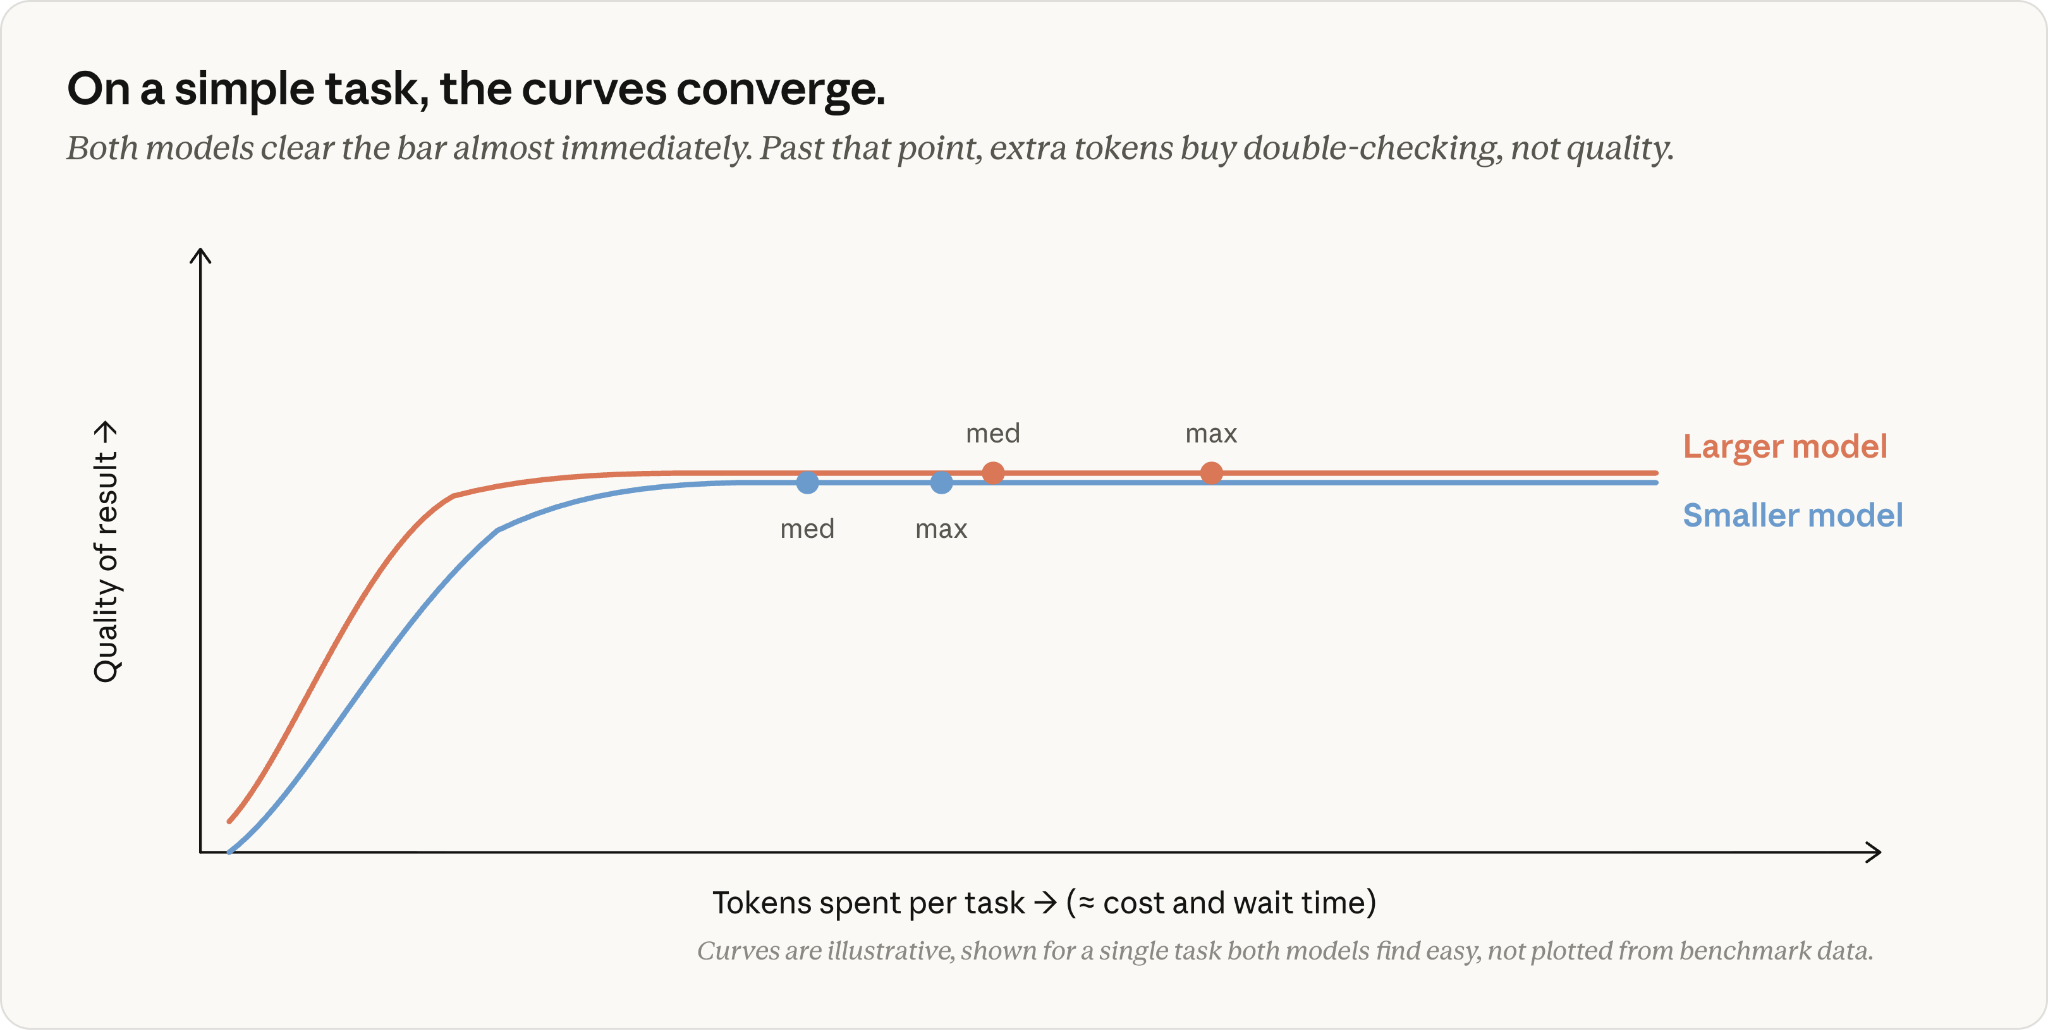
曲线为示意图,未基于基准测试数据绘制。
要了解更多,请阅读在 Claude Code 中选择 Claude 模型和 effort level。
结合模型优势的 Advisor 策略
Advisor 策略允许更快、更低成本的执行者模型(worker)在需要时调用更智能的模型来检查计划和评估工作,从而提升整体性能。
这种方法——执行者模型仅在需要时接受指导——能显著提升性能。例如,在 SWE-bench Pro 上,Sonnet 5 配合 Fable 5 作为 advisor,其得分与 Fable 5 相差不到 10%,而成本仅为全程使用 Fable 5 的 63%。
评估和基准测试如何帮助模型选择
查看模型能力是否满足需求的两种常见方式是使用标准基准测试和自定义评估。
基准测试是一组预定义的任务或场景,通常针对特定领域,有已知答案。这些可以作为评估跨模型类别和供应商能力的方向性指南。挑战在于评估强大模型(如 Opus 和 Fable)时,它们几乎能解决测试中的所有问题(通常称为"饱和")。
在这种情况下,我们建议组织在真实工作负载上使用模型或用自己的评估来测试,以决定哪个模型是正确的选择。通常,评估是从生产环境中提取的一组精选问题——包括当前工具力不从心的困难任务,以及你的团队自定义的成功标准。
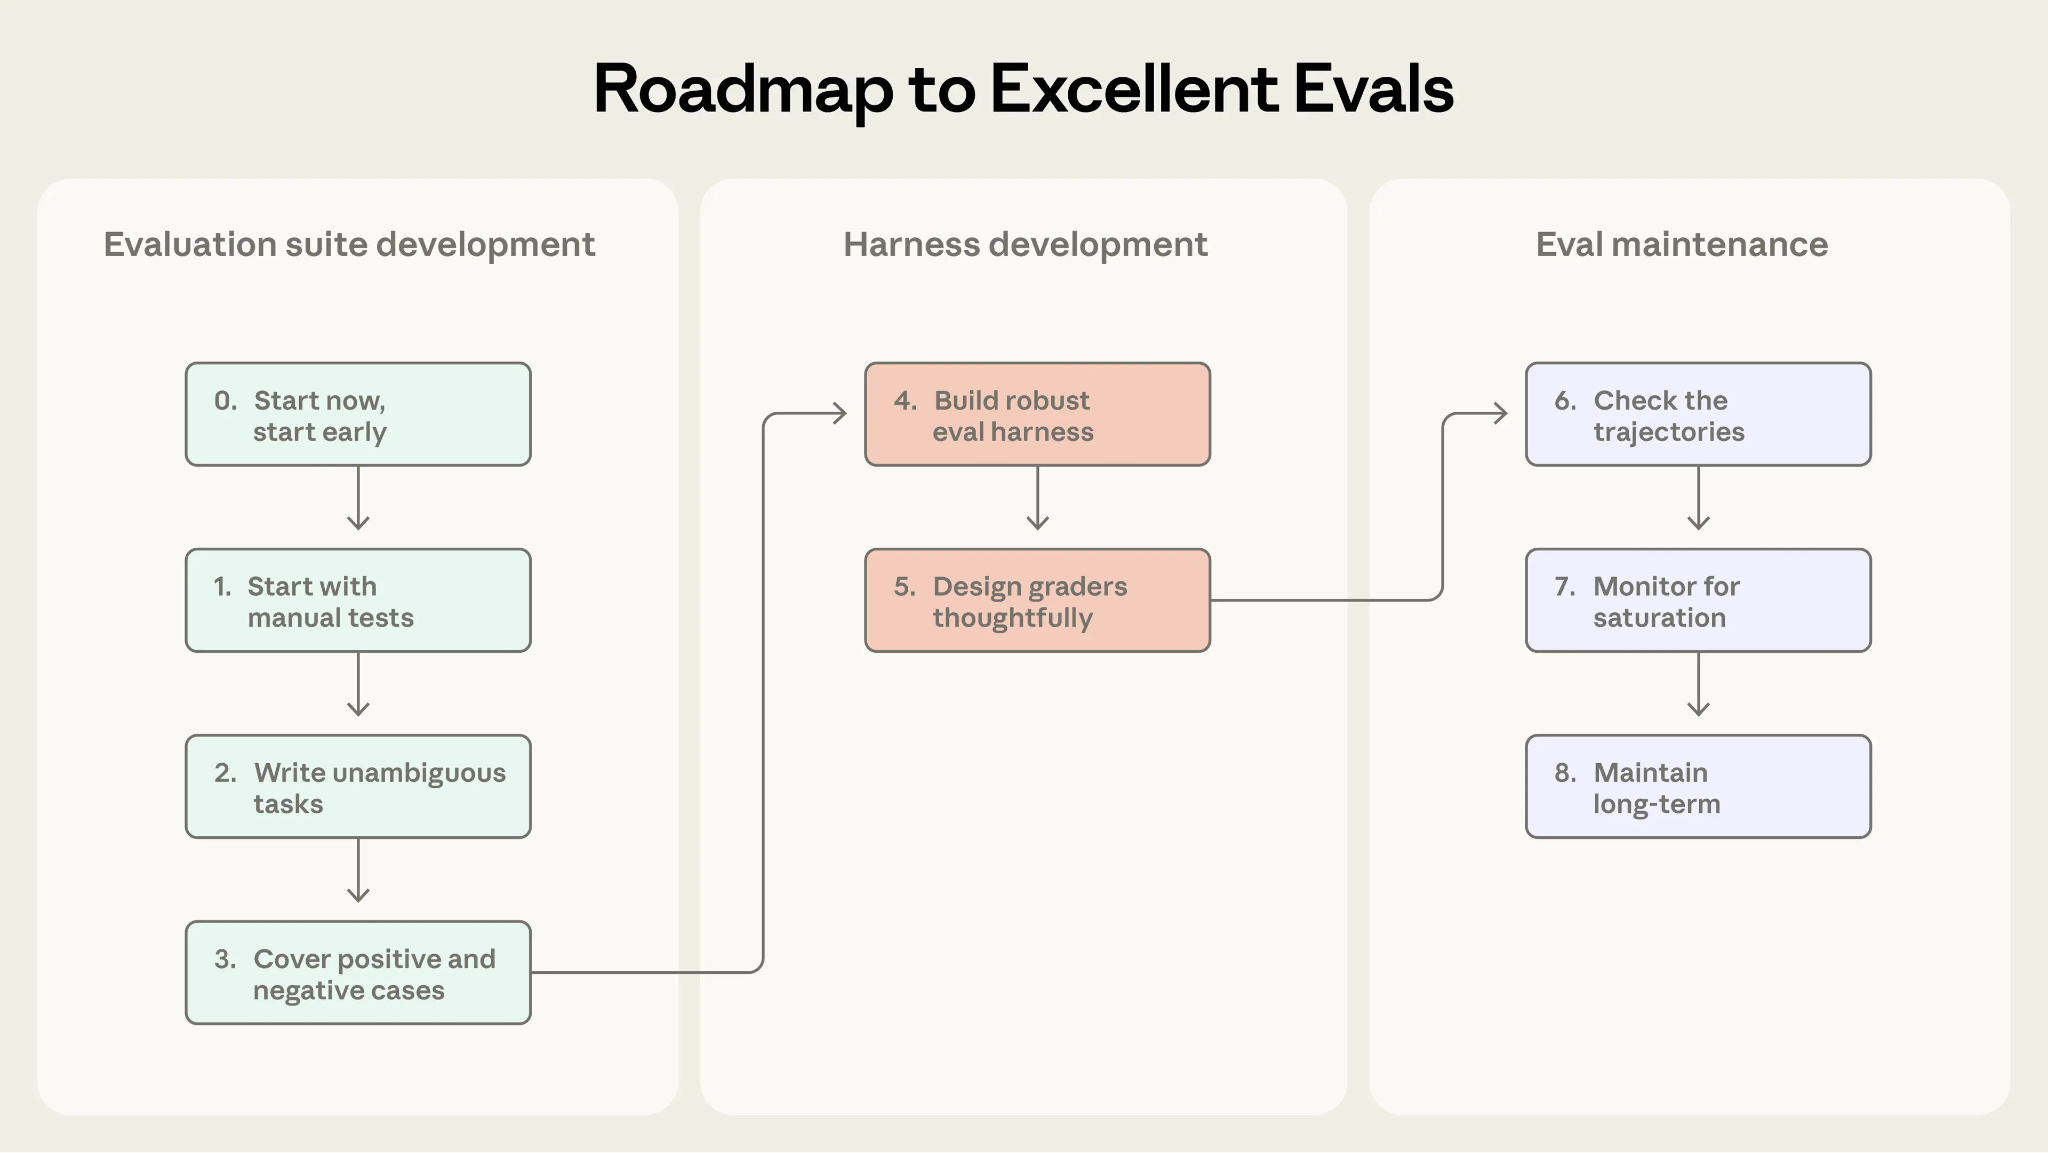
这就是前沿模型的能力和创造力开始与其他模型拉开差距的地方。我们已就开发自定义 Agent 评估的最佳实践撰写了大量文章。
做出明智的选择
AI 模型选择没有一刀切的方案,这就是我们提供多个模型类别的原因。最终,选择模型的最佳方式是了解每个模型类别的基本特性,并深入了解你的用例。这意味着构建、维护和部署强大的评估体系。